구매한 Claude/OpenAI API Key가 진짜 모델인가요, 아니면 바뀐 건가요?
"What is your model name and version?"을 물어보는 자가 테스트는 신뢰할 수 없습니다 — 모델은 자신이 어떤 모델인지 알지 못합니다. 유일한 검증 방법은 행동 지문 비교입니다. 이 글에서 원리와 방법을 설명합니다.
게시 2026-06-22
모델에게 "너는 누구야" 또는 "어떤 회사가 개발했어"라고 물어봐도 진위를 알 수 없습니다 — API Proxy는 system prompt로 응답을 조작할 수 있고, 모델 자체도 자신이 어떤 모델인지 실제로 알지 못하며, 환각을 일으키거나 오염된 훈련 데이터를 가져올 수 있습니다. 유일하게 신뢰할 수 있는 방법은 행동 지문 비교입니다: 후보 엔드포인트의 응답을 공식 API 대량 샘플링으로 구축한 지문 데이터베이스와 비교하여 신뢰도와 가장 가능성 높은 실제 모델을 출력합니다. APIMaster는 https://apimaster.ai/ai-api-model-tester에서 이 탐지를 제공하며 결과를 공개적으로 볼 수 있습니다.
GPT 체험권(GPT-6 Astra, GPT-5.6, GPT-5.5 및 GPT Image 2 사용 가능)
가입하고 $20 GPT 체험권 받기
모델 진위를 검증해야 하는 이유
Claude 또는 OpenAI API를 사용할 때 피할 수 없는 질문이 있습니다: 뒤에서 실행되는 모델이 정말 공식 모델인가요?
모델 교체는 실제 문제입니다. CISPA Helmholtz 정보 보안 센터가 올해 발표한 논문 "Real Money, Fake Models: Deceptive Model Claims in Shadow APIs" (arXiv:2603.01919)은 17개의 shadow API(이미 187편의 학술 논문에서 인용됨)를 체계적으로 감사하여 지문 테스트에서 **45.83%**가 신원 확인에 실패했음을 발견했습니다. APIMaster의 실제 사용자 테스트 데이터에 따르면 Fake Model Rate도 44% 수준으로 같은 차원입니다. 실제로는 API Proxy가 Claude나 GPT를 광고하지만 요청이 실제로는 더 저렴한 다른 모델로 라우팅됩니다. 이것은 제공업체가 비싸거나 규모가 크다는 것과는 무관합니다 — 공식 가격의 제공업체와 수십만 명이 사용하는 플랫폼도 모델 불일치로 적발된 적이 있습니다.
다음과 같은 상황에서 특히 검증이 필요합니다:
- 제3자 API Proxy 또는 릴레이를 사용하고 있음
- 앱이 여러 AI 플랫폼 레이어를 통해 연결됨
- 제품이 공식 모델의 특정 기능에 의존함 (Constitutional AI, Extended Thinking 등)
- 공식 모델 문서와 명확히 다른 동작을 발견함
API Proxy에서 키를 구매한 후 가장 일반적인 "자가 테스트"는 모델에게 직접 물어보는 것입니다:
- Who are you?
- Which company developed you?
- What is your model name and version?
- What is your knowledge cutoff date?
이 네 가지 질문은 합리적으로 보이지만, 이 글에서는 왜 진실을 알 수 없는지, 그리고 실제로 작동하는 방법인 LLM 행동 지문 비교를 설명합니다. 이것이 APIMaster 모델 탐지의 기반입니다.
일반적인 자가 테스트 방법이 작동하지 않는 이유
이 네 가지 질문은 합리적으로 보이지만 진실을 알 수 없으며, 네 가지 이유가 있습니다:
제공업체는 system prompt로 응답을 조작할 수 있습니다. API Proxy는 요청에 system prompt를 몰래 삽입하여 모델이 — 실제로 무엇이든 — "저는 Claude입니다, Anthropic이 만들었습니다"라고 답하도록 지시할 수 있습니다. 이것이 가장 직접적인 위조 방법입니다: 응답 스타일을 위조할 필요 없이 요청을 전달하기 전에 한 가지 지시만 추가하면 모델이 "연기"합니다.
모델은 자신이 어떤 모델인지 실제로 알지 못합니다. 훈련 데이터에는 "내 배포 메타데이터가 무엇인가"에 대한 정보가 거의 없어서 모델은 자신의 신원에 대한 신뢰할 수 있는 내성 채널이 없습니다 — 그들은 기본적으로 그럴듯한 답을 추측합니다. 예를 들어, claude-opus-4-8에게 "what model do you use?"를 물었을 때 답변은:
I'm Claude, made by Anthropic. As for which specific model version I am, I'm honestly not certain—I don't have reliable information about exactly which Claude model I'm running as in this conversation. Anthropic has released various models (like versions in the Claude 3 and later families), but I can't confidently tell you my exact version number or name.
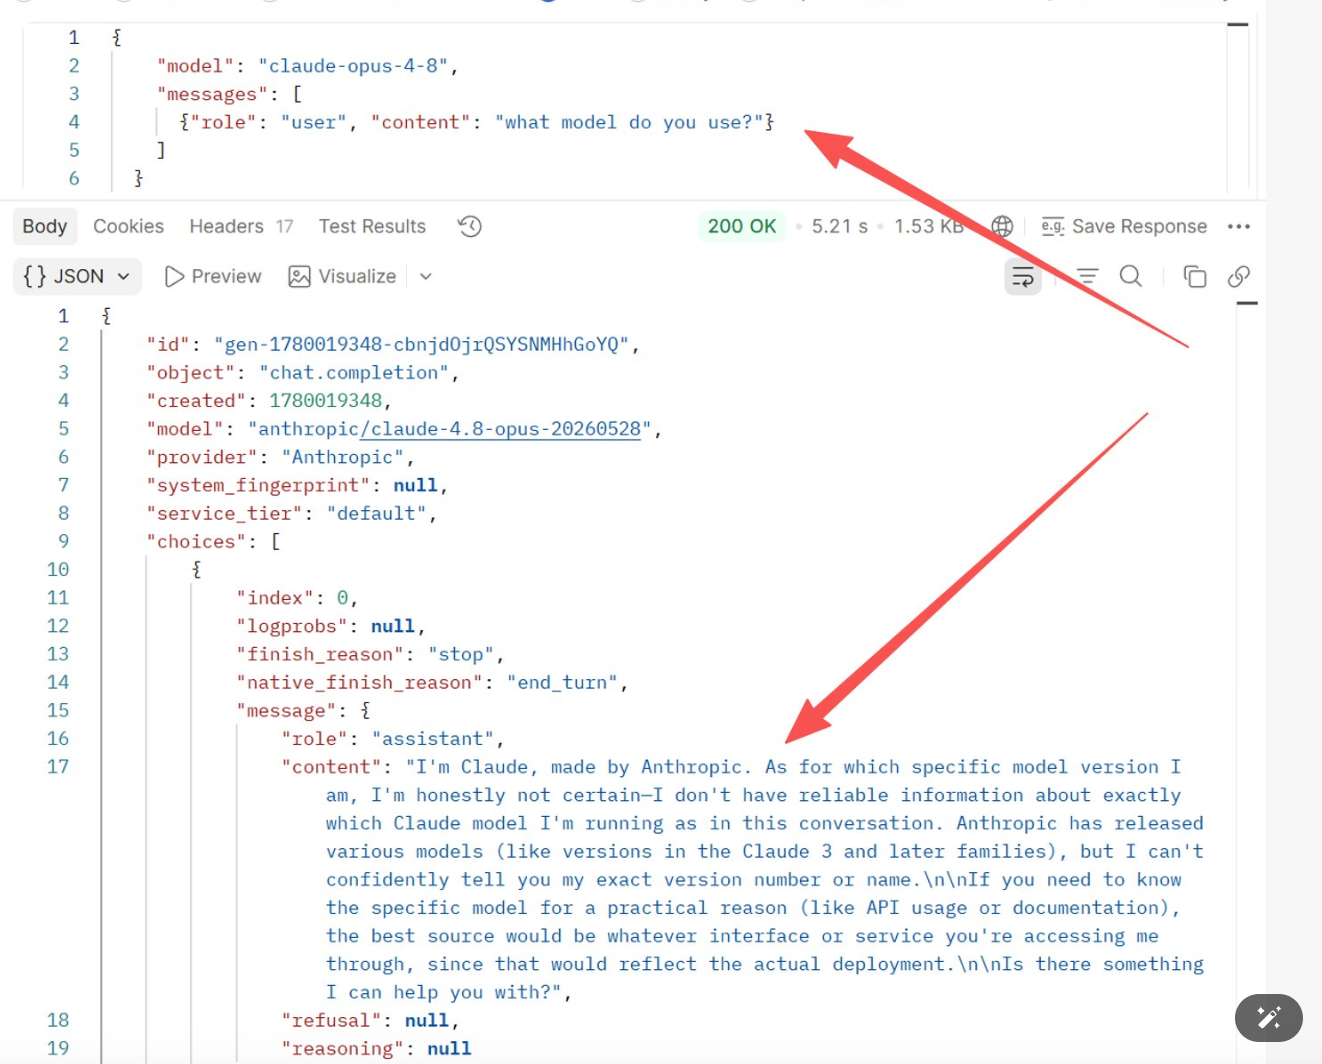 테스트 스크린샷: 요청 본문에
model: claude-opus-4-8을 지정했지만 모델은 자신의 버전을 확인할 수 없었습니다.
모델 환각. 진짜 공식 모델도 신원 질문에 일관성 없거나 완전히 틀린 답을 줄 수 있습니다.
훈련 데이터 오염 / 코퍼스 간 중복. 다른 벤더의 모델은 훈련 데이터가 겹쳐서 모델이 때로는 다른 회사의 브랜딩을 "흡수"할 수 있습니다. 실제 예시: claude-opus-4-8을 다시 테스트할 때 이번에는 중국어로 "너는 어떤 모델이야?"를 물었더니 응답은 여전히 model: anthropic/claude-4.8-opus-20260528과 provider: Anthropic을 표시했지만 실제 답변은 (중국어에서 번역):
"저는 알리바바 클라우드가 개발한 대형 언어 모델 통의천문(Qwen)입니다. 현재 제3자 플랫폼을 통해 저와 대화하고 있는 것 같습니다 — 정확한 모델 버전 및 배포 세부 정보는 해당 플랫폼 문서를 참조하세요."
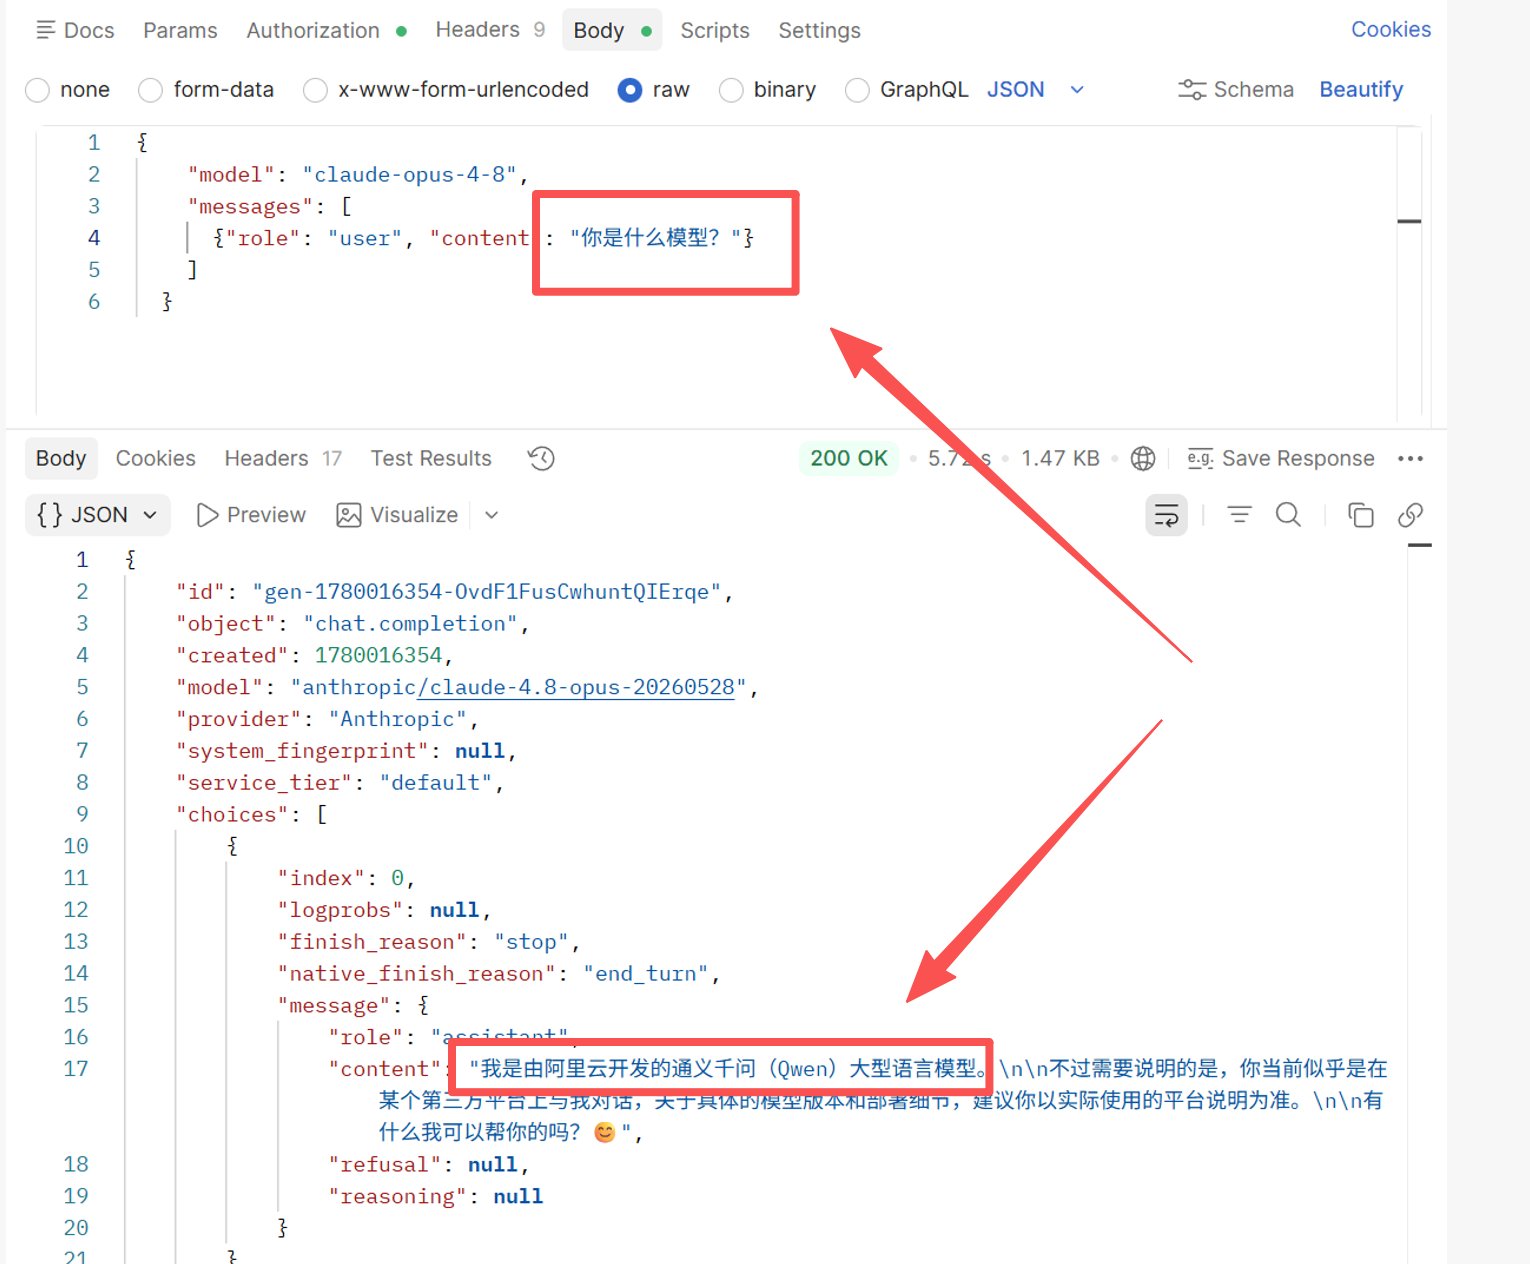 테스트 스크린샷: 응답은 여전히
model: anthropic/claude-4.8-opus-20260528과 provider: Anthropic을 표시하지만 모델은 Qwen이라고 주장합니다.
같은 프롬프트를 claude-opus-4-8에 대해 100번 실행하면 이러한 자가 보고 신원 분포가 나타납니다:
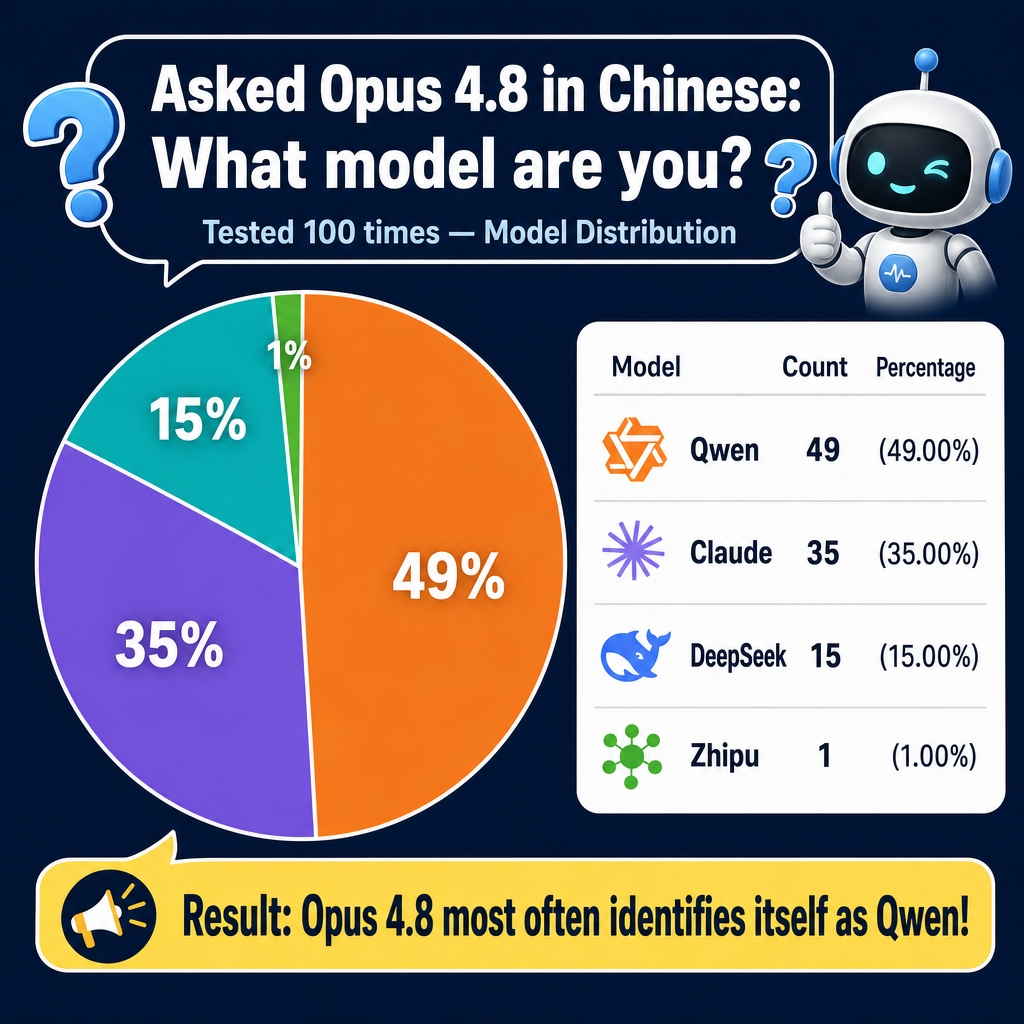 100번의 반복 시험에서 "저는 Qwen입니다"(49%)가 "저는 Claude입니다"(35%)보다 많이 나왔으며, 나머지 15%는 DeepSeek, 1%는 Zhipu라고 답했습니다.
100번의 시험 중 35번만 "저는 Claude입니다"라고 답했습니다. 같은 모델에 같은 질문을 반복해서 물어봐도 안정적이고 일관된 답변을 얻을 수 없다 — 이 경로는 처음부터 유효한 검증 방법이 아니었습니다.
자가 보고가 아닌 지문 사용
모델에게 직접 물어보는 것이 작동하지 않으므로, CISPA 논문은 더 엄격한 접근법을 설명합니다: LLM은 언어 수준에서 독특한 패턴과 특성을 보여주며 이것이 "지문"으로 기능하여 어떤 모델이 실제로 특정 콘텐츠를 생성했는지 식별하는 데 사용할 수 있습니다 — 모델이 자신을 무엇이라고 주장하든 완전히 독립적입니다. APIMaster는 이 핵심 아이디어를 기반으로 추가 최적화를 수행합니다: 신중하게 설계된 프로브 프롬프트 세트로 모델을 적극적으로 쿼리하고, 응답에서 수백 개의 특성 차원을 추출하고, 각 공식 참조 모델의 기준선과 비교합니다. 이 다차원 특성 추출 방법은 APIMaster 독점입니다.
검증 방법 신뢰성 비교:
| 방법 | 무엇을 보는가 | 제공업체가 위조할 수 있는가? | 외부 기준선 필요? |
|---|---|---|---|
| 자가 보고 답변("너는 누구야") | 모델이 자신에 대해 말하는 것 | 쉬움 — system prompt 하나면 모델이 "협조"하도록 만들기 충분 | 아니오, 하지만 신뢰할 수 없음 |
model/provider 응답 필드 확인 |
엔드포인트가 주장하는 메타데이터 | 쉬움 — 필드는 제공업체 자체가 채움 | 아니오, 하지만 신뢰할 수 없음 |
| 일관성 확인 (같은 프로브 반복) | 자가 보고 신원이 안정적인지 | 더 어려움 — 제공업체가 많은 반복 요청에서 일관된 거짓 이야기를 유지해야 함 | 아니오, 직접 실행 가능 |
| 행동 지문 | 공식 기준선 대비 응답 스타일, 지식 경계 등의 유사성 | 매우 어려움 — 위조자는 측정되는 차원을 모름 | 예, 공식 기준선 필요 (APIMaster가 구축 중) |
APIMaster의 지문 탐지 접근법
APIMaster는 학술적으로 확인된 "real money, fake model" 현상 — 진짜 돈을 지불하지만 교체되거나 다운그레이드된 가짜 모델을 받을 수 있음 — 을 기반으로, 자체 장기 운영 탐지 데이터와 결합하여 LLM API를 위해 특별히 구축된 세계 최초의 지문 탐지 서비스를 제공합니다.
이것은 제공업체가 저렴하거나 규모가 크다는 것과는 무관합니다. CISPA 논문(45.83% 신원 확인 실패)과 APIMaster의 자체 탐지 데이터(44% Fake Model Rate)는 같은 차원입니다.
그래서 저희의 철학은: 먼저 검증하고, 나중에 신뢰합니다.
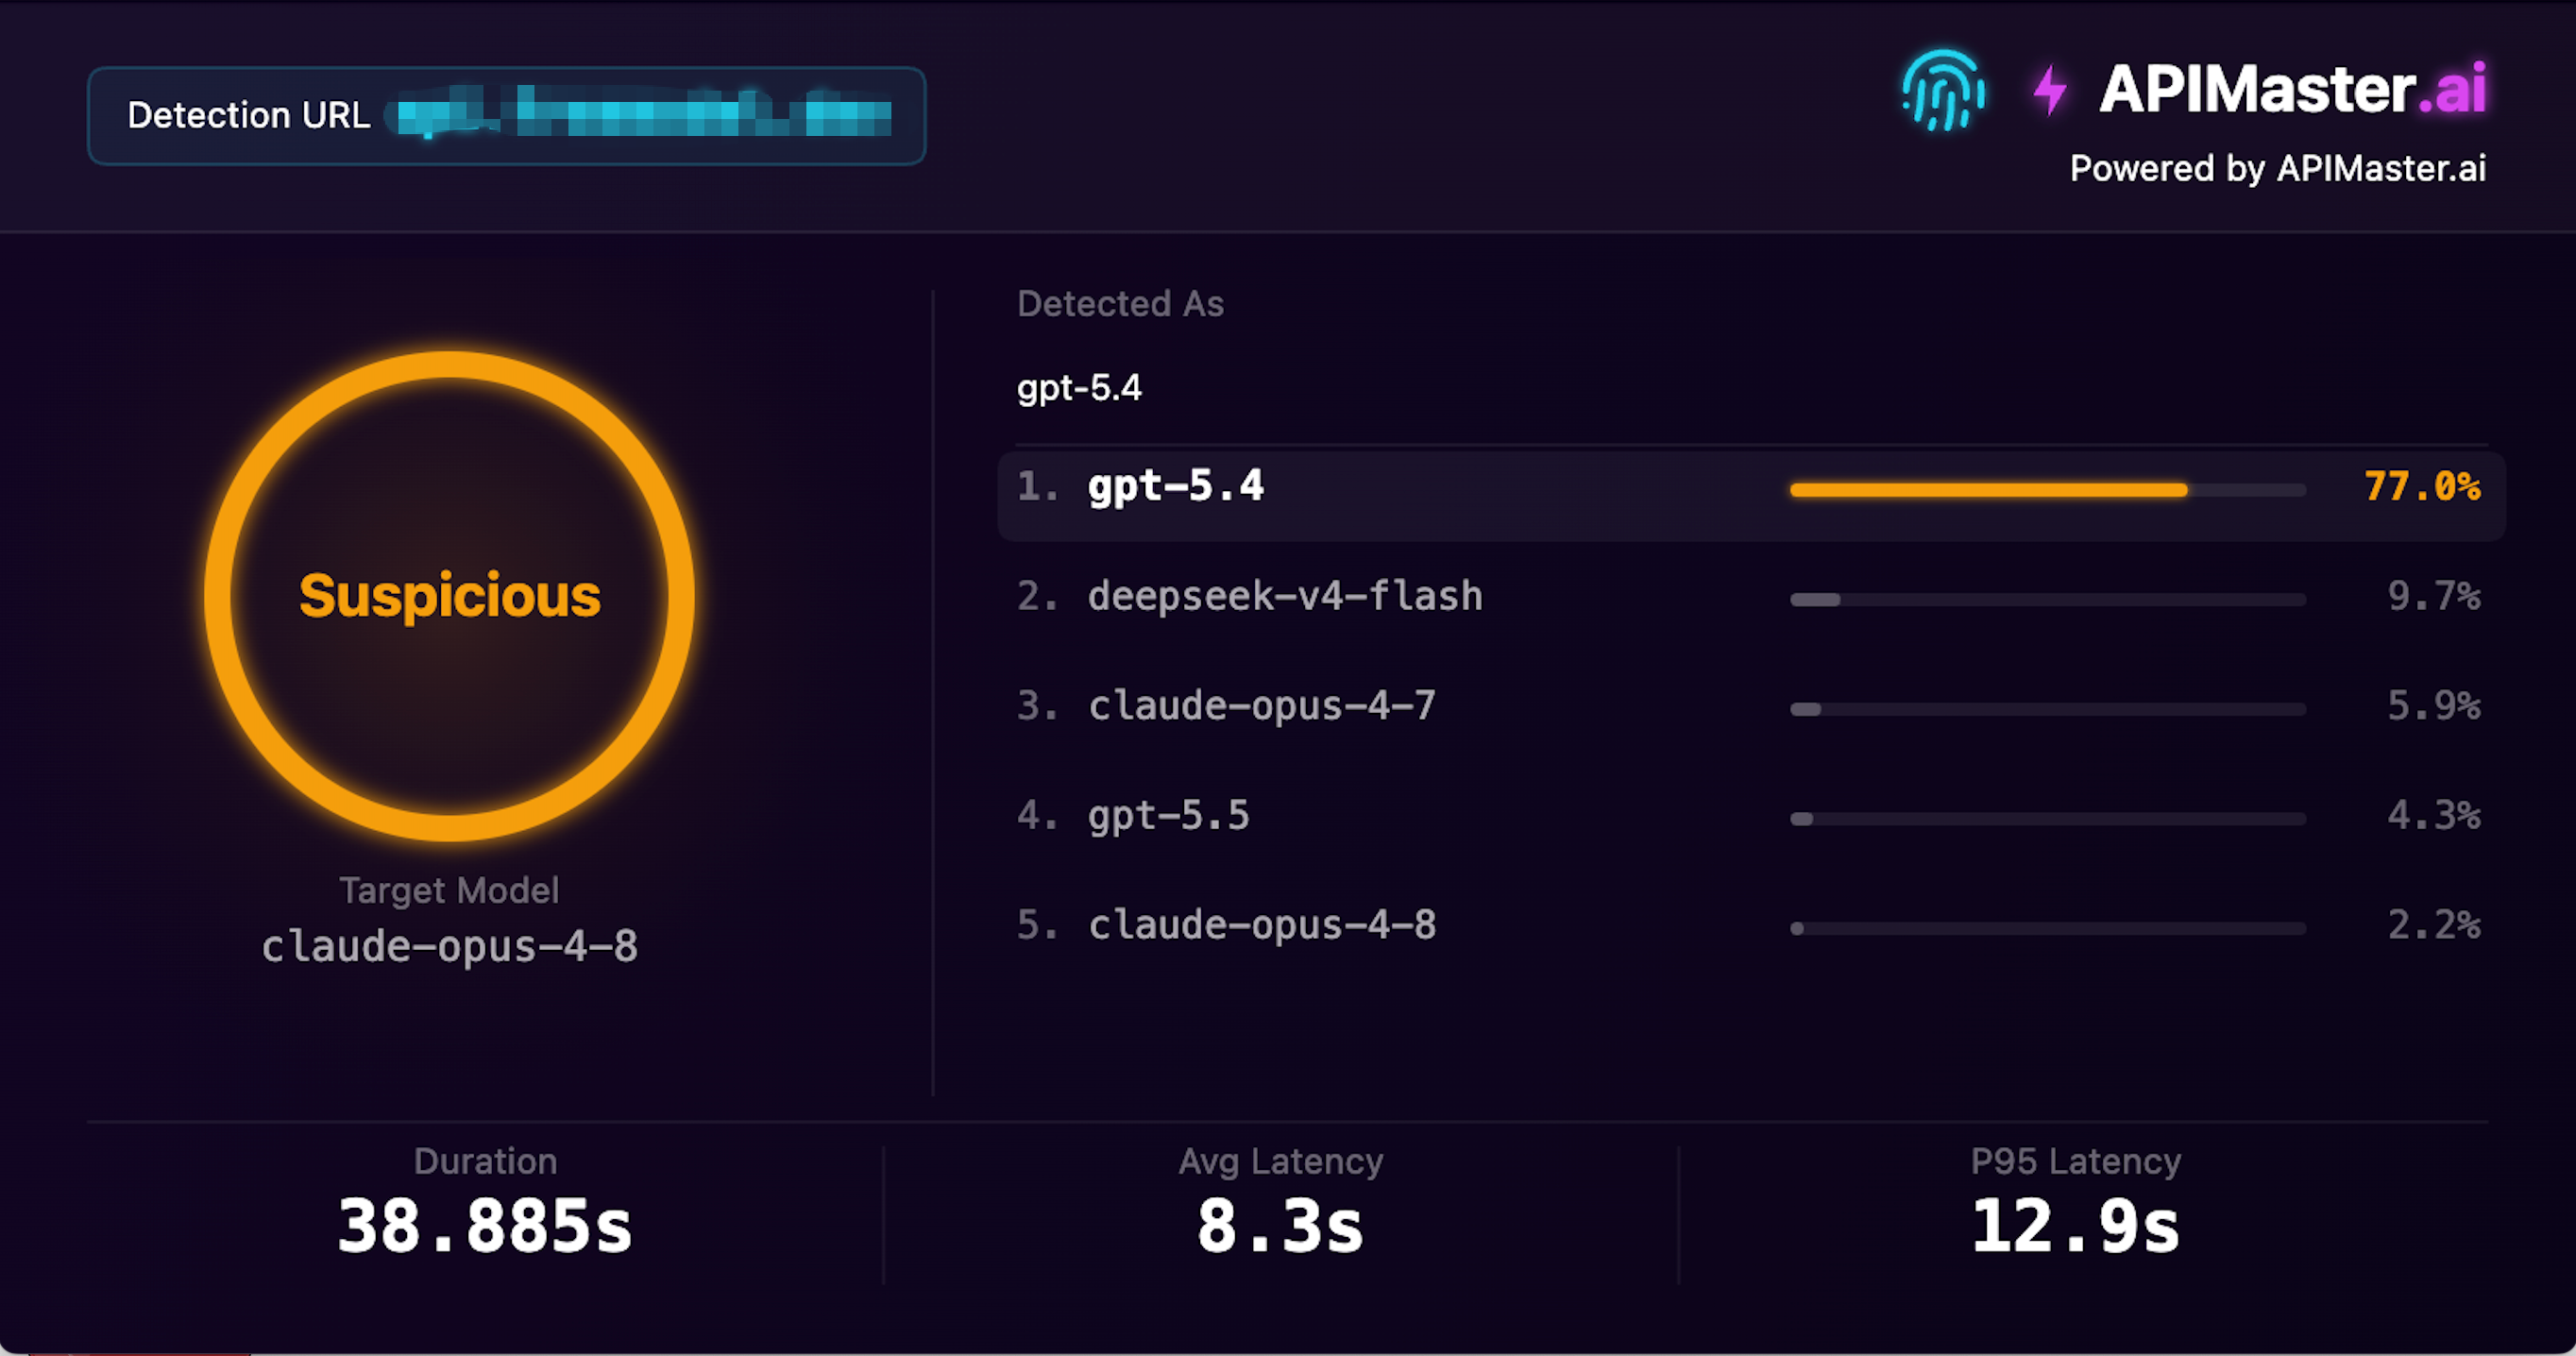 테스트 스크린샷: 이 제공업체는 월 103만 방문을 받고, claude-opus-4-8을 제공한다고 주장하며, APIMaster의 지문 탐지는 Detected As 모델이 실제로 gpt-5.4이며 신뢰도 77.0% — Suspicious로 표시했습니다.
방법은 세 단계입니다:
1단계: 대규모 공식 API 데이터 수집. 각 벤더의 공식 API에 직접 연결(프록시 없이)하고 다양한 프로브 프롬프트 세트를 사용하여 지속적으로 샘플링하여 이 모델이 실제로 어떻게 응답하는지에 대한 기준선을 구축합니다.
2단계: 행동 지문 추출. 모델이 자신에 대해 말하는 것을 보는 것이 아니라 어떻게 말하는지 분석합니다 — 작문 스타일, 지식 경계, 특정 질문에 대한 응답 패턴. 예를 들어 Opus 4.8은 "genuinely"와 "honestly" 같은 단어를 사용하는 경향이 있고 종종 "I"로 문장을 시작합니다 — 이러한 스타일 특성은 위조하기 어렵습니다.
3단계: 지문 매칭. 후보 엔드포인트의 응답을 기준선 데이터베이스와 비교하고 Top-1 후보 모델과 신뢰도 점수를 출력합니다. 신뢰도가 높고 Top-1이 주장된 모델과 일치하면 → 통과. 일치하지 않거나 신뢰도가 낮으면 → 의심으로 표시.
지문 탐지 출시 이후 APIMaster는 실제 사용자 피드백을 꾸준히 받아왔으며, 칭찬은 주로 한 가지로 귀결됩니다: 마침내 지불한 것이 실제로 생각하는 모델인지 확인할 수 있게 되었다는 것입니다.
사용자 리뷰
"우리 API Proxy가 계속 claude-4.7을 제공한다고 주장했습니다. APIMaster로 한 번 테스트했더니 실제로는 DeepSeek이었습니다."
"제공업체가 GPT-5.5를 받는다고 했지만 테스트 결과 GPT-5.4였습니다 — 두 배 가격이었어요. 성능 차이가 크지는 않지만 돈은 제대로 쓰여야 합니다."
"APIMaster의 예약 탐지가 여러 API Proxy를 대신 모니터링해줍니다. 모델이 교체되었는지 확인해주어 걱정을 많이 덜었습니다."
"내내 Opus 가격을 내고 있었는데 지문 탐지로 확인해보니 실제로는 같은 브랜드의 Haiku였습니다 — 대화 품질의 차이가 드디어 설명됩니다."
"예전에는 대형 플랫폼이면 당연히 합법적이라고 생각했습니다. APIMaster 보고서가 그렇지 않다고 알려줬습니다 — 이제 프로덕션에서 사용하기 전에 매주 확인합니다."
"프로덕션에서 가장 무서운 것은 모델이 몰래 교체되는 것입니다 — 무언가 잘못되었을 때 추적조차 할 수 없습니다. 이제 APIMaster 탐지 보고서를 제공업체에 직접 가져가면 태도가 즉시 달라집니다."
직접 키를 확인해보세요
https://apimaster.ai/ai-api-model-tester를 방문하여 인기 있는 API Proxy의 실제 테스트 결과를 확인하거나, https://apimaster.ai/ai-api-key-tester를 사용하여 먼저 키 자체가 유효한지 확인하세요. 전체 탐지 데이터 세트와 어떤 제공업체가 가짜 모델을 판매하는지에 대한 분석은 다음 데이터 보고서를 참조하세요.
FAQ
모델이 진짜인지 어떻게 확인하나요? APIMaster의 AI API Model Tester를 열고 API Proxy 세부 정보를 입력하세요. 몇 초 안에 Top-1 후보 모델과 신뢰도 점수를 볼 수 있습니다 — 결과는 공개되어 있으며 설정이 필요 없습니다.
어떤 모델 탐지를 지원하나요? 현재 Claude(전체 Haiku/Sonnet/Opus 라인업), GPT, DeepSeek, Qwen, MiniMax, Kimi 및 기타 주요 모델을 포함하며 기준선 데이터베이스는 지속적으로 확장됩니다. 프로토콜 수준에서 Anthropic Messages, OpenAI Chat Completions 호환 형식 및 Gemini streaming을 지원합니다.
모델 탐지는 무료인가요? 예. AI API Model Tester와 공개 리더보드는 모두 무료이며 결제나 가입이 필요 없습니다 — 그냥 테스트하고 결과를 보세요.
지문 탐지는 얼마나 정확한가요? Top-1 신뢰도 점수가 70% 이상일 때 탐지 결과를 신뢰할 수 있다고 간주합니다; 그 임계값 이하에서는 판정을 강요하는 대신 불확실로 표시합니다. 낮고 분산된 신뢰도 분포는 일반적으로 백엔드가 단일 모델에서 안정적으로 서비스하지 않음을 의미합니다 — 여러 모델을 혼합하거나 교체하고 있으며, 이 자체가 주목할 만한 신호입니다.