
Gemini 4 Argon: il modello frontier di Google per flussi di lavoro lunghi
Google ha annunciato Gemini 4 Argon il 30 settembre 2026 per ingegneria del software complessa, lavoro della conoscenza aziendale e difesa informatica. Consulta i prezzi riportati, i benchmark, l’accesso Fairwind limitato e le route Gemini disponibili oggi.
Published 2026-09-30 · Updated 2026-10-01
Gemini 4 Argon è il primo modello di frontiera Gemini 4 annunciato da Google, ma non è ancora un'API destinata al pubblico generale. Google ha annunciato Argon il 30 settembre 2026, posizionandolo per l'ingegneria del software a lungo termine, il lavoro di conoscenza aziendale e la difesa informatica. Il primo accesso descritto da Google avviene tramite il programma Fairwind per difensori informatici fidati; non è stata annunciata un'ampia API a pagamento o una data di lancio di Google AI Ultra.
La capacità principale è fino a 1 milione di token di output segnalati in una risposta, rispetto ai limiti di output molto più piccoli a cui gli sviluppatori sono abituati sulla maggior parte delle attuali API di frontiera. Google afferma che i suoi team interni stanno già utilizzando Argon per refactoring di grandi dimensioni, migrazioni da C/C++ a Rust, ottimizzazione della memoria e altre attività a lungo orizzonte. La tabella di benchmark pubblicata con l'annuncio riporta 77,9% su DeepSWE v1.1, 68,9% sul lavoro di conoscenza dell'indice Vals, 19,6% sull'Harvey's Legal Agent Benchmark e ottimi risultati su diverse altre valutazioni aziendali e di codifica. Questi sono risultati pubblicati dal fornitore, non un test APIMaster indipendente.
Il prezzo di lancio riportato è di 2$/1 milione di token di input e 10$/1 milione di token di output, con input memorizzati nella cache riportati a circa 0,10$/1 milione di token. Si prevede che Google passerà a $4/$20 dopo il periodo introduttivo, ma il catalogo API pubblico e un percorso Argon generalmente disponibile dovrebbero essere trattati come fonte di verità quando compaiono. Al momento Argon non ha un percorso APIMaster confermato.
Per un'API Gemini che puoi effettivamente chiamare oggi, APIMaster ha percorsi attivi per Gemini 3.8 Flash, Gemini 3.7 Flash e Gemini 3.6 Flash. Come verificato il 1 ottobre 2026, il percorso Gemini 3.8 Flash attivo più basso era di 0,2999$ di input / 1,4993$ di output per 1 milione di token, con sette percorsi attivi. Controlla la scheda live prima di inviare traffico perché la capacità del percorso e i prezzi possono cambiare.
| ID modello | Prezzo di listino ufficiale (per 1 milione di input/output) | APIMaster prezzo attuale | Percorsi attivi | Sconto | Scheda modello |
|---|---|---|---|---|---|
gemini-4-argon |
Intro segnalato $ 2 / $ 10; più tardi $ 4 / $ 20 | Nessun percorso pubblico confermato | 0 | — | Visualizza la scheda modello |
gemini-3.8-flash |
$ 1,50 / $ 7,50 | $ 0,2999 / $ 1,4993 | 7 | circa l'80% | Visualizza lo sconto |
gemini-3.7-flash |
$ 1,50 / $ 7,50 | $ 0,2999 / $ 1,4993 | 7 | circa l'80% | Visualizza sconto |
gemini-3.6-flash |
$ 1,50 / $ 7,50 | $ 0,36 / $ 1,80 | 4 | circa il 76% | Visualizza lo sconto |
gpt-6-astra |
$ 10 / $ 50 | $ 0,4465 / $ 2,2327 | 14 | circa il 96% | Visualizza lo sconto |
claude-fable-5-1 |
$ 10 / $ 50 | $ 2,3755 / $ 11,8774 | 7 | circa il 76% | Visualizza lo sconto |
claude-opus-5-5 |
$ 4 / $ 20 | $ 1,3359 / $ 6,6794 | 9 | circa il 67% | Visualizza sconto |
Istantanea dei prezzi verificata il 1° ottobre 2026. I prezzi APIMaster sono la rotta attiva più bassa restituita dall'endpoint del mercato pubblico in quel momento; la carta del mercato live è autorevole. I prezzi e la disponibilità dell'Argon sono informazioni di lancio riportate, non un elenco APIMaster confermato.
Prova GPT(GPT-6 Astra, GPT-6 Sol, GPT-5.6 e GPT-5.5 disponibili)
Registrati e ricevi $20 di prova GPT
Cos'è Gemini 4 Argon?
Gemini 4 Argon è il primo membro annunciato della generazione Gemini 4 di Google. A differenza di un lancio rivolto al consumatore incentrato sulle funzionalità di chat, Google ha presentato Argon come un modello di lavoro che richiede molti passaggi, utilizza grandi quantità di contesto e può durare a lungo prima di produrre un risultato utile. Per una cronologia più ampia della formazione e della disponibilità di Gemini 4, vedere la Panoramica di Gemini 4.
Le tre aree di lancio sono:
- Ingegneria del software: modifiche su scala di repository, debugging, migrazioni e cicli di agenti di codifica.
- Lavoro di conoscenza aziendale: ricerca legale, finanziaria e operativa in cui il modello deve tenere traccia di molti vincoli e fonti.
- Difesa informatica: analisi difensiva della sicurezza rilasciata per prima ai partecipanti fidati del programma Fairwind di Google.
Questo posizionamento è importante per gli acquirenti API. Un punteggio benchmark elevato non equivale a disponibilità pubblica, latenza prevedibile o contratto di fatturazione stabile. Fino a quando Argon non sarà elencato nella documentazione dell'API di Google con un ID modello e limiti, gli sviluppatori dovrebbero considerare l'annuncio come un aggiornamento di funzionalità e accesso, non come un endpoint che possono chiamare.
Cosa può fare l'Argon?
Massimale di output di un milione di token
L'annuncio di Google evidenzia un massimo di 1 milione di token di output in un'unica risposta. Se il limite viene fornito come descritto, potrebbe cambiare il modo in cui gli sviluppatori progettano refactoring di grandi dimensioni, report lunghi e flussi di lavoro degli agenti in più fasi: il modello potrebbe essere in grado di mantenere più risultati intermedi di un'attività in una risposta invece di forzare l'applicazione a dividere il lavoro in molte chiamate di continuazione.
Quel numero non deve essere confuso con la produzione utile garantita, la capacità di contesto, i limiti di velocità o l’utilizzo della produzione a prezzi accessibili. Una risposta da un milione di token è anche una fattura da un milione di token al tasso di output. I team dovrebbero misurare la qualità del completamento, il comportamento di annullamento, la latenza e il costo totale delle attività rappresentative prima di considerare il limite come un motivo per rimuovere i checkpoint sul lato dell'applicazione.
Lavoro di ingegneria e conoscenza a lungo orizzonte
Google descrive i progetti interni di Argon che includono l'ottimizzazione della memoria del data center, le migrazioni da C/C++ a Rust e l'accelerazione del decodificatore video. Questi esempi sono segnali utili sul carico di lavoro previsto, ma si tratta di studi di casi interni piuttosto che di valutazioni pubbliche riproducibili. Il test di produzione corretto consiste nell'eseguire un archivio fisso o un set di documenti rispetto ad Argon e alle alternative attuali con gli stessi strumenti, budget e rubrica di valutazione.
La difesa informatica innanzitutto
L'accesso iniziale a Fairwind è una parte significativa della storia del prodotto. Ciò significa che i primi utenti sono difensori informatici fidati piuttosto che la popolazione generale degli sviluppatori. Ciò può consentire a Google di imparare dai flussi di lavoro difensivi ad alto rischio mantenendo limitati gli accessi, i controlli sugli abusi e i cicli di feedback.
Significa anche che “annunciato” non significa “disponibile in AI Studio, Gemini API o APIMaster”. Gli sviluppatori non devono copiare un identificatore indovinato come gemini-4-argon nella produzione e dedurre il successo da un'etichetta di percorso di terze parti.
Risultati benchmark: cosa ha pubblicato Google
Lo screenshot di confronto dell'annuncio elenca Argon accanto a GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. I valori rappresentativi mostrati nella tabella pubblicata includono:
| Valutazione | Gemelli 4 Argon | GPT-6 Astra | Claude Favola 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index lavoro di conoscenza | 68,9% | 63,1% | 65,8% | 67,0% |
| BancoAutomazione | 51,3% | 41,4% | 31,4% | 42,5% |
| Agente finanziario Vals v2 | 65,4% | 53,5% | 58,9% | 58,6% |
| Benchmark degli agenti legali di Harvey | 19,6% | 5,4% | 6,7% | 3,8% |
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Banco del codice Vibe | 91,9% | 89,6% | 90,3% | 90,3% |
| Terminale-banco 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| Banco CWE v1 | 68,0% | 68,0% | 58,0% | 67,0% |
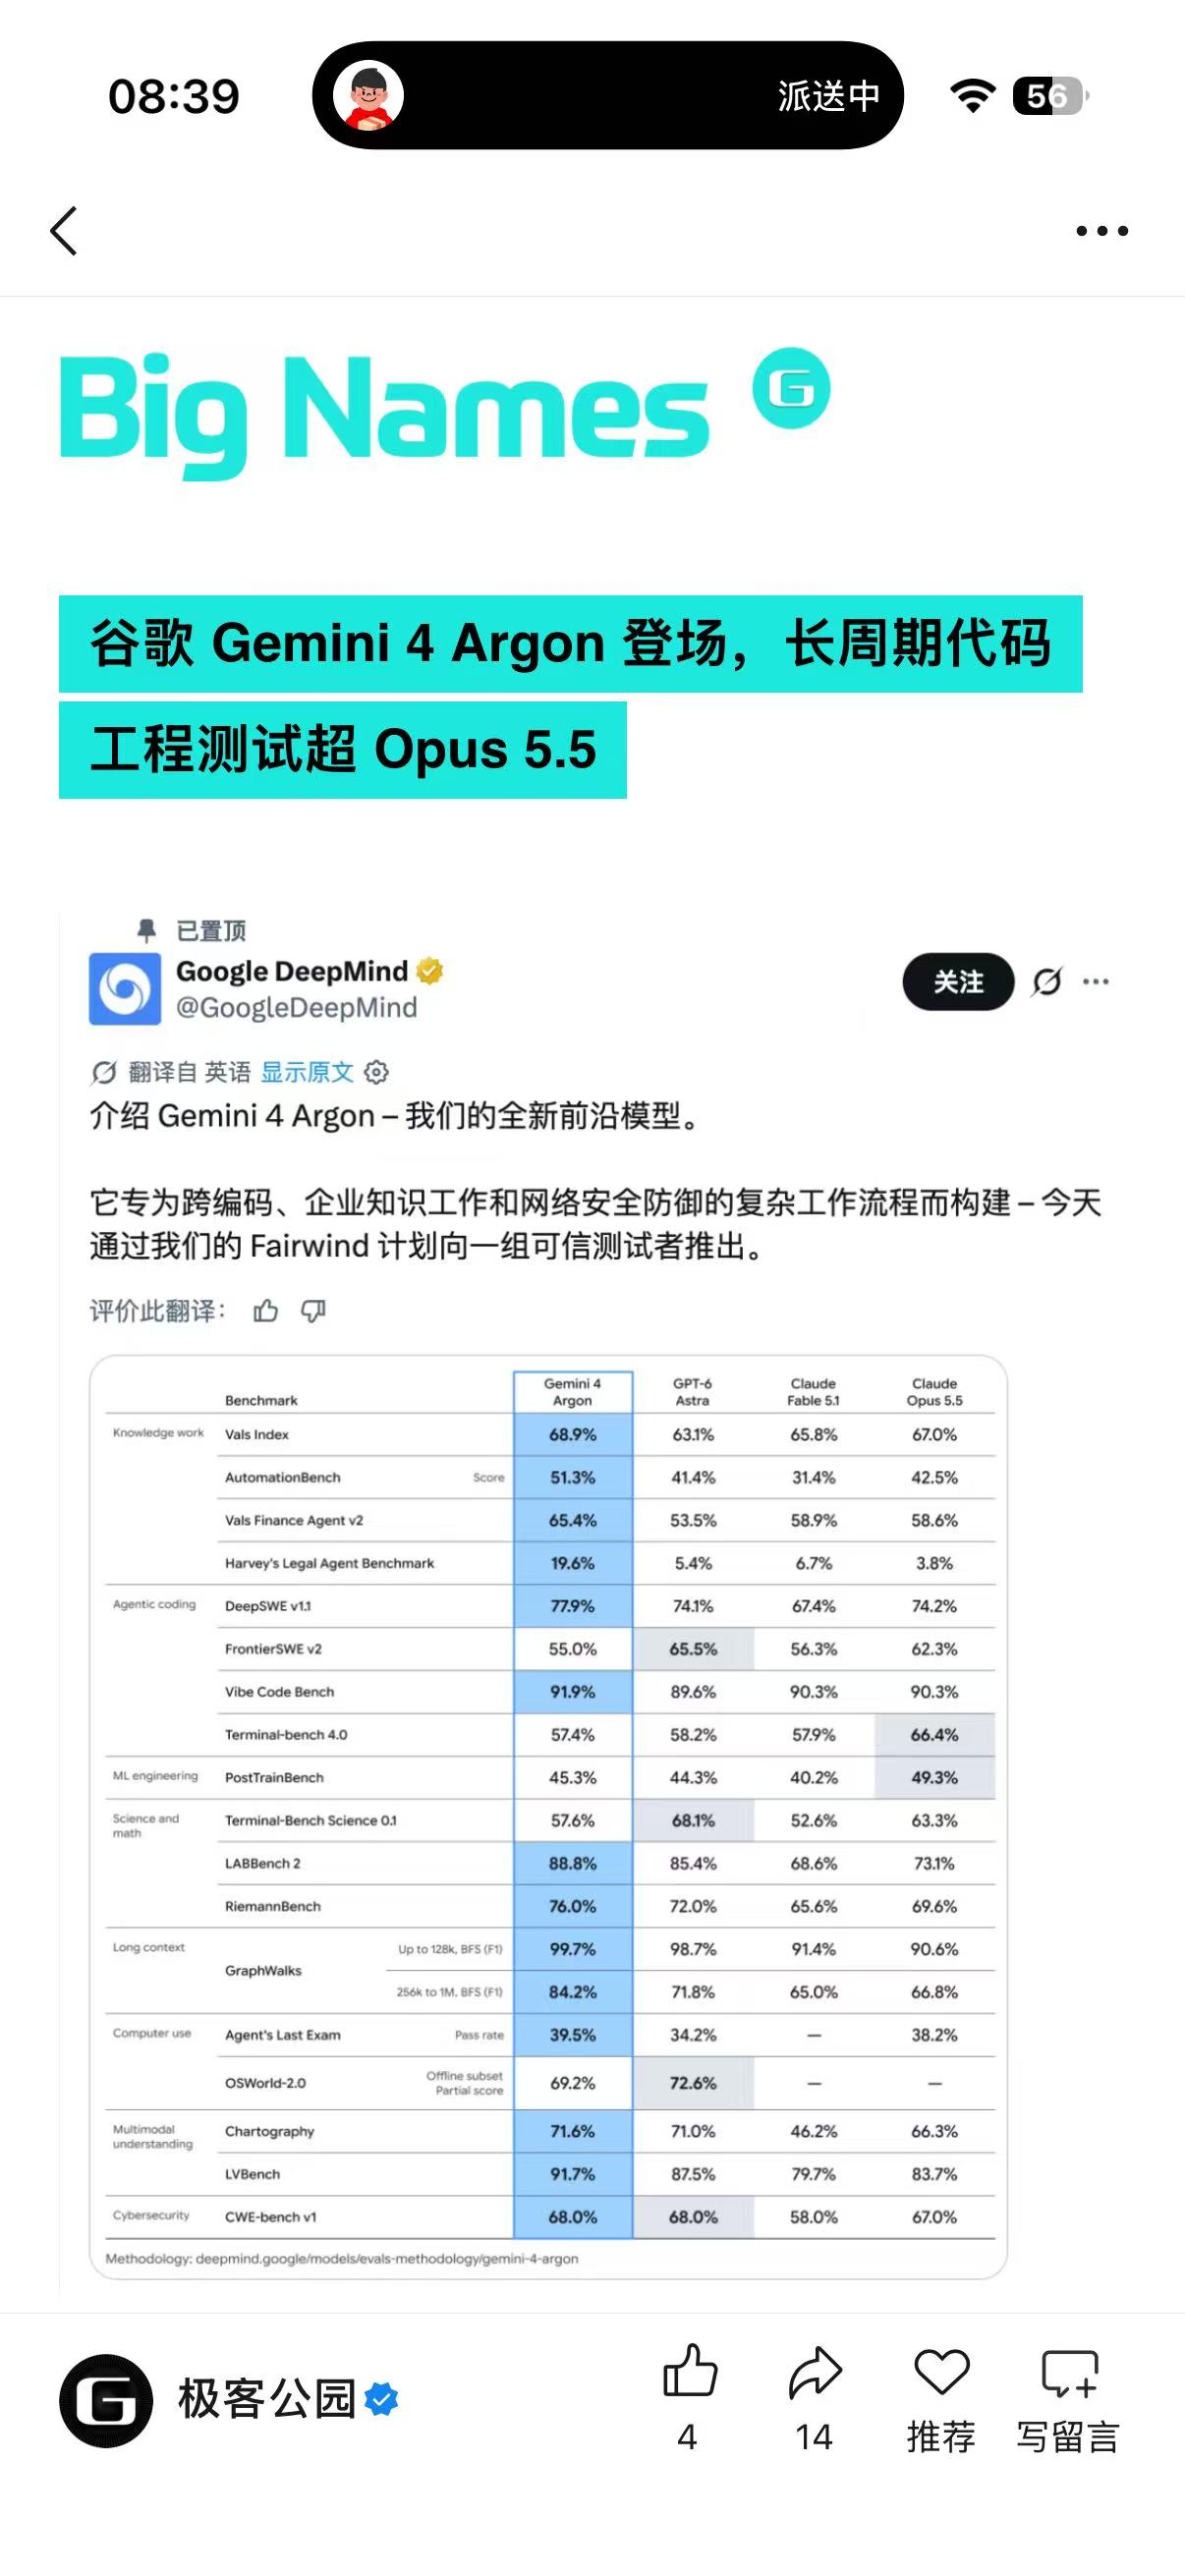
Immagine editoriale: screenshot fornito dall'utente. Il post visibile è attribuito a GEEKPark e include un'immagine di un presunto annuncio di Google DeepMind; questa non è una cattura originale e autenticata in modo indipendente del post X di Google. Verifica il post e la metodologia originali prima di considerare i punteggi come convalidati in modo indipendente.
La tabella non è uniformemente favorevole all’Argon. Lo screenshot mostra GPT-6 Astra in vantaggio su FrontierSWE v2 e OSWorld-2.0, mentre Claude Opus 5.5 guida Terminal-bench 4.0 e PostTrainBench. Ecco perché un titolo come “L’Argon vince ogni benchmark” sarebbe fuorviante. I risultati di Google supportano una conclusione più specifica: l'Argon è competitivo o in vantaggio in molte valutazioni a lungo orizzonte, aziendali e di lavoro difensivo, mentre altri modelli rimangono più forti su determinate attività di utilizzo del computer, codifica e post-formazione.
Il commento indipendente è già diviso. L'analisi artificiale descrive l'Argon come legato a GPT-6 Astra nel suo indice di intelligenza e evidenzia tassi di allucinazioni inferiori e comportamento migliorato degli agenti. Altri ricercatori si chiedono quanto di quel punteggio derivi dal comportamento di rifiuto, dalla ponderazione del benchmark e da una metodologia che sta ancora cambiando. Trattare tali affermazioni come analisi esterne, non come sostituti delle definizioni di riferimento primarie.
Chi ha annunciato Argon su X?
La conversazione di lancio si concentra su un piccolo gruppo di resoconti ufficiali e di analisi:
- Google DeepMind ha annunciato Argon e il primo modello di accesso Fairwind.
- Google ha sottolineato il limite massimo di produzione di un milione di token e i risultati di frontiera.
- Sundar Pichai ha spiegato perché Google ha condiviso l'annuncio in anticipo e ha sottolineato l'uso interno, i guardrail di sicurezza e l'accesso graduale.
- Logan Kilpatrick ha discusso del prezzo introduttivo segnalato di $ 2/$ 10 e del piano per espandere l'accesso.
- Analisi artificiale ha pubblicato un confronto indipendente e un commento sull'indice di intelligenza.
La risposta ricorrente degli sviluppatori è semplice: i benchmark sembrano interessanti, ma la maggior parte degli sviluppatori non può ancora chiamare Argon. Le domande pratiche riguardano quando verrà aperta l'API a pagamento, se Google AI Ultra riceverà l'accesso, quanto saranno stabili i lavori da milioni di token e se il prezzo di lancio sopravvivrà alla disponibilità generale.
Quali modelli Gemini possono utilizzare gli sviluppatori oggi?
###Gemini 3.8Flash
Gemini 3.8 Flash è il percorso Gemini più potente attualmente visibile nel mercato APIMaster. Si tratta di una scelta pratica per lavori di testo ad alto volume, assistenti di codifica, estrazione strutturata e flussi di lavoro multimodali in cui un modello di livello Flash rilasciato è più importante del posizionamento di frontiera di Argon.
Apri la scheda flash Gemini 3.8 live per i fornitori attuali, i segnali sanitari e i prezzi dei percorsi. L'attuale istantanea del mercato ha rilevato sette percorsi attivi, con il percorso più basso a circa $ 0,2999 / $ 1,4993 per 1 milione di token di input/output.
Gemini 3.7 Flash e 3.6 Flash
Gemini 3.7 Flash e Gemini 3.6 Flash rimangono scelte di riserva utili quando un carico di lavoro necessita di più canali, un profilo di capacità specifico o una versione del modello già testata dall'applicazione. L'istantanea ha rilevato sette percorsi 3.7 attivi e quattro percorsi 3.6 attivi.
Questi non sono sostituti dell’Argon nelle dichiarazioni di capacità. Sono disponibili opzioni Gemini per creare l'integrazione, raccogliere le linee di base del carico di lavoro e preparare successivamente un cambio di modello controllato.
Altre alternative di frontiera su APIMaster
Se la tua attività è disponibile ora anziché attendere Argon, APIMaster espone anche percorsi attivi per GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. La tabella sopra utilizza la stessa istantanea del marketplace per tutti e tre, quindi il confronto separa il prezzo di riferimento ufficiale dal percorso APIMaster attivo più basso.
La scelta giusta dipende dal carico di lavoro:
| Carico di lavoro | Inizia con | Perché |
|---|---|---|
| Grandi anelli di agente di codifica | Gemini 3.8 Flash o GPT-6 Astra | Confronta il completamento del repository, i turni di riparazione e l'affidabilità delle chiamate agli strumenti. |
| Analisi giuridica e aziendale | Claude Opus 5.5 o Favola 5.1 | Misura la qualità delle citazioni, il tracciamento dei vincoli e il comportamento di rifiuto. |
| Integrazione Gemini ad alto volume | Gemini 3.7 Flash o 3.8 Flash | Mantieni stabile la forma del provider e dell'API mentre l'accesso ad Argon è limitato. |
| Ricerca sulla difesa della sicurezza | Un modello attualmente rilasciato con strumenti approvati | Non inviare dati sensibili a un percorso Argon non verificato. |
Come prepararsi per l'API Argon
Non creare codice di produzione attorno a un endpoint non confermato. Invece:
- Mantieni la versione di prompt, strumenti, dispositivi di input e criteri di valutazione.
- Stabilire una linea di base con una rotta Gemini rilasciata e almeno un'alternativa non Gemini.
- Registrare la qualità dell'output accettato, il successo delle chiamate allo strumento, la latenza, i tentativi, l'utilizzo dei token e i costi.
- Quando Google pubblica la documentazione dell'API Argon, testa l'ID modello esatto in un ambiente separato.
- Promuoverlo solo dopo aver verificato il modello di scheda, i limiti, la politica di sicurezza e il comportamento di fatturazione.
Una richiesta minima compatibile con OpenAI tramite APIMaster si presenta così una volta scelto un modello rilasciato:
curl "$API_BASE/v1/chat/completions" \
  -H "Authorization: Bearer $APIMASTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.8-flash",
    "messages": [{"role": "user", "content": "Summarize this repository plan."}]
  }'
Crea un account APIMaster, aggiungi una chiave nella console, utilizza l'API base e seleziona un modello che appare nel marketplace live. Non sostituire gemini-3.8-flash con gemini-4-argon finché Google e il catalogo dei percorsi non confermano tale identificatore.
In conclusione
Gemini 4 Argon è un annuncio importante perché si rivolge a quella parte della frontiera in cui la qualità del modello viene misurata completando flussi di lavoro lunghi e disordinati anziché rispondendo a una richiesta. La tabella pubblicata da Google presenta ottimi risultati in termini di lavoro di conoscenza, agenti legali, ingegneria del software e valutazioni di sicurezza informatica, e il tetto di output riportato di un milione di token è insolitamente ambizioso.
Ma il lancio è deliberatamente organizzato. A partire dal 1 ottobre 2026, Argon non è un'API Gemini generalmente disponibile o un percorso APIMaster confermato. L'azione utile oggi è confrontare il tuo carico di lavoro reale su un percorso Gemini rilasciato, in particolare Gemini 3.8 Flash, o su un altro canale di frontiera attivo, quindi mantenere il cablaggio di valutazione pronto per l'eventuale API pubblica di Argon.
Domande frequenti
Gemini 4 Argon è disponibile tramite l'API Gemini?
Non generalmente. Google ha annunciato Argon il 30 settembre 2026 e ha descritto l'accesso iniziale tramite Fairwind per i difensori informatici fidati. Un ampio lancio dell'API a pagamento non è stato confermato nelle informazioni pubbliche qui trattate.
Posso utilizzare Gemini 4 Argon tramite APIMaster?
Non esiste un percorso APIMaster Argon confermato a partire dal 1° ottobre 2026. Utilizza un modello rilasciato mostrato nel mercato live, come gemini-3.8-flash, e controlla la scheda del modello prima dell'integrazione.
Quanto costa Gemini 4 Argon?
Il prezzo di lancio riportato è di 2 dollari per 1 milione di token di input e 10 dollari per 1 milione di token di output, con input memorizzati nella cache riportati vicino a 0,10 dollari. È stato segnalato anche un prezzo successivo di $ 4 / $ 20. Considera entrambi come report di lancio finché la pagina dei prezzi dell'API pubblica di Google non pubblica il contratto finale.
Qual è il contesto o il limite di output di Argon?
Il materiale di lancio evidenzia fino a 1 milione di token di output in un'unica risposta. Gli sviluppatori devono ancora verificare i limiti di contesto, i limiti di velocità, la latenza, il comportamento di troncamento e la fatturazione nell'eventuale documentazione dell'API.
Argon batte GPT-6 Astra e Claude Opus 5.5 ovunque?
No. Il confronto di Google mostra Argon in vantaggio o competitivo in molte valutazioni elencate, ma GPT-6 Astra e Claude Opus 5.5 guidano attività selezionate di codifica, utilizzo del computer e post-formazione. La metodologia di benchmark e l'adattamento del carico di lavoro sono importanti.
Quale modello Gemini dovrei usare oggi?
Inizia con il percorso Gemini rilasciato che corrisponde al tuo carico di lavoro e appare nel catalogo live. Lo snapshot del 1° ottobre 2026 ha rilevato percorsi APIMaster attivi per Gemini 3.8 Flash, Gemini 3.7 Flash e Gemini 3.6 Flash. Verifica il prezzo attuale e la disponibilità del fornitore della scheda Flash Gemini 3.8.
Fonti e note di verifica
- Google DeepMind su X: account dell'annuncio principale a cui fa riferimento lo screenshot del lancio.
- Google su X: annuncio del prodotto e inquadramento degli accessi.
- Sundar Pichai su X: accesso graduale, uso interno e contesto di sicurezza.
- Logan Kilpatrick su X — Gemini API e ha riportato una discussione introduttiva sui prezzi.
- Analisi artificiale su X: benchmark indipendente e commento sull'Intelligence Index.
- Modelli Google DeepMind Gemini: riferimento ufficiale alla famiglia di modelli.
- Documentazione del modello Google AI for Developers: la disponibilità del modello API deve essere verificata qui all'apertura di Argon.
I dati di riferimento e i dettagli di accesso all'Argon in questo articolo sono attribuiti al materiale di lancio e chiaramente separati dall'istantanea del mercato APIMaster in tempo reale. Ricontrolla entrambi prima di prendere una decisione sulla produzione.