
Gemini 4 Carbon Overview
Présentation de Gemini 4 Carbon : programmation sur de longues durées, raisonnement, cybersécurité, évaluations indépendantes, tarifs de lancement de $2/$10 et accès à l’API publique.
Published
Gemini 4 Carbon est le nouveau modèle phare Gemini 4 annoncé par Google le 2026-10-28, avec des améliorations en programmation sur de longues durées, en raisonnement complexe et en cyberdéfense. À son lancement, il occupait la première place de l’Artificial Analysis Intelligence Index v5 avec 59 points. Dans le classement indépendant Coding Agent Index, il se plaçait deuxième derrière Claude Opus 5.5.
Google a annoncé des tarifs de lancement de $2 en entrée / $10 en sortie par million de tokens, avec $0.10 pour les entrées en cache. L’accès initial passe par le Fairwind Program, pour une sélection d’acteurs de confiance de la cyberdéfense. Aucune date d’ouverture générale aux développeurs, aux entreprises et aux particuliers n’a été annoncée. Au moment de cette vérification, APIMaster ne propose aucune route publique pour Carbon ; il n’y a donc aucun tarif ni aucune remise APIMaster pour Carbon à citer.
Pour une API Gemini disponible dès aujourd’hui, comparez Argon et 3.8 Flash. Tous les prix ci-dessous sont en USD par million de tokens en entrée / en sortie ; les remises sont calculées à partir des tarifs de lancement Standard actuels de Google.
| Identifiant du modèle | Tarif officiel actuel / de référence | Tarif APIMaster actuel | Routes actives | Remise | Fiche du modèle |
|---|---|---|---|---|---|
| Gemini 4 Carbon (identifiant d’API publique non confirmé) | Lancement : $2 / $10 ; standard : $4 / $20 | Aucune route publique | 0 | — | Vérifier la disponibilité de Carbon |
gemini-4-argon |
Actuellement $2 / $10 ; $4 / $20 à partir du 2026-12-01 | À partir de $0.834142 / $4.170712 | 4 | Jusqu’à ~58.3% de remise | Comparer les routes Argon |
gemini-3.8-flash |
Actuellement $0.75 / $3.75 ; $1.50 / $7.50 à partir du 2027-01-01 | À partir de $0.302013 / $1.510063 | 7 | Jusqu’à ~59.7% de remise | Comparer les routes Flash |
Vérifié le 2026-10-31. Seules les routes publiques status=1 sans libellé d’exclusivité client sont comptabilisées. Les tarifs d’Argon vont de $0.834142 à $2 en entrée / de $4.170712 à $10 en sortie ; ceux de 3.8 Flash vont de $0.302013 à $1.50 / de $1.510063 à $7.50. La fiche en temps réel de la place de marché fait foi. Le lien Carbon est une recherche de disponibilité, et non la confirmation d’un identifiant d’API Google utilisable.
Essai GPT(GPT-6 Astra, GPT-6 Sol, GPT-5.6, GPT-5.5, gpt-5.6-luna, gpt-5.6-sol, gpt-5.6-terra, gpt-6.1-sol, gpt-6-astra, gpt-6-sol et gpt-6-luna disponibles)
Inscrivez-vous et recevez $20 d’essai GPT
Le rôle de Carbon : un travail soutenu sur des tâches d’ingénierie complexes
Carbon poursuit l’orientation d’Argon vers le travail de longue durée : bugs difficiles dans de grands dépôts, systèmes de bas niveau, ingénierie en plusieurs étapes et correctifs de sécurité nécessitant des vérifications répétées.
Google rapporte que ses équipes internes ont vu Carbon fonctionner pendant des jours, persévérer malgré des impasses, repérer des bugs subtils et produire des correctifs. Il s’agit d’un retour d’utilisation interne, et non d’une promesse selon laquelle chaque requête à l’API publique s’exécutera en continu pendant des jours.
La question pratique est de savoir si le modèle peut garder l’objectif en vue, utiliser des outils pour tester ses hypothèses et se reprendre après l’échec d’une approche. La maintenance des dépôts, les migrations et les travaux de sécurité bénéficient de modifications qui peuvent être acceptées et vérifiées.
Selon Artificial Analysis, Carbon dispose d’une fenêtre de contexte de 1M de tokens, accepte du texte, des images, de la vidéo et de la parole en entrée, et produit du texte. La compréhension vidéo ne démontre pas une capacité de génération vidéo, et la capacité du contexte ne détermine pas la longueur maximale de sortie d’une réponse.
Sources : Annonce de Google · Évaluation d’Artificial Analysis.
Gemini 4 Carbon face à Argon : quelle est l’ampleur des améliorations ?
Le tableau de lancement de Google montre des gains en raisonnement, en contexte long, en compréhension multimodale et en programmation. Les résultats sélectionnés ci-dessous proviennent de la comparaison publiée par Google, et non de tests d’APIMaster.
| Évaluation | Gemini 4 Carbon | Gemini 4 Argon | Évolution |
|---|---|---|---|
| AA Index v5.0, capacités générales | 59 | 50 | +9 points d’indice |
| Vals Index v2.2, travail intellectuel | 70.4% | 69.2% | +1.2 point de pourcentage |
| SWE-sweep, programmation agentique | 9.6% | 4.3% | +5.3 points de pourcentage |
| Terminal-Bench 4.0 (AA) | 65.2% | 57.1% | +8.1 points de pourcentage |
| Agents' Last Exam v1.1, utilisation d’un ordinateur | 77.4% | 69.0% | +8.4 points de pourcentage |
| GraphWalks, 256K–1M BFS F1 | 96.2% | 84.2% | +12.0 points de pourcentage |
| RiemannBench, mathématiques | 80.0% | 76.0% | +4.0 points de pourcentage |
Les gains varient selon les tâches. GraphWalks et Terminal-Bench progressent nettement ; Vals Index évolue plus modestement. Le score SWE-sweep fait plus que doubler par rapport à Argon, mais sa valeur absolue reste de 9.6%, ce qui laisse une marge de progression considérable pour les tâches de programmation difficiles.
Pour le développement web, Google annonce 1768 Elo, une quatrième place et une progression de 89 Elo sur WebDev Arena. Le choix en pratique doit toujours inclure une vérification de la mise en page mobile, des interactions et de la complétude fonctionnelle.
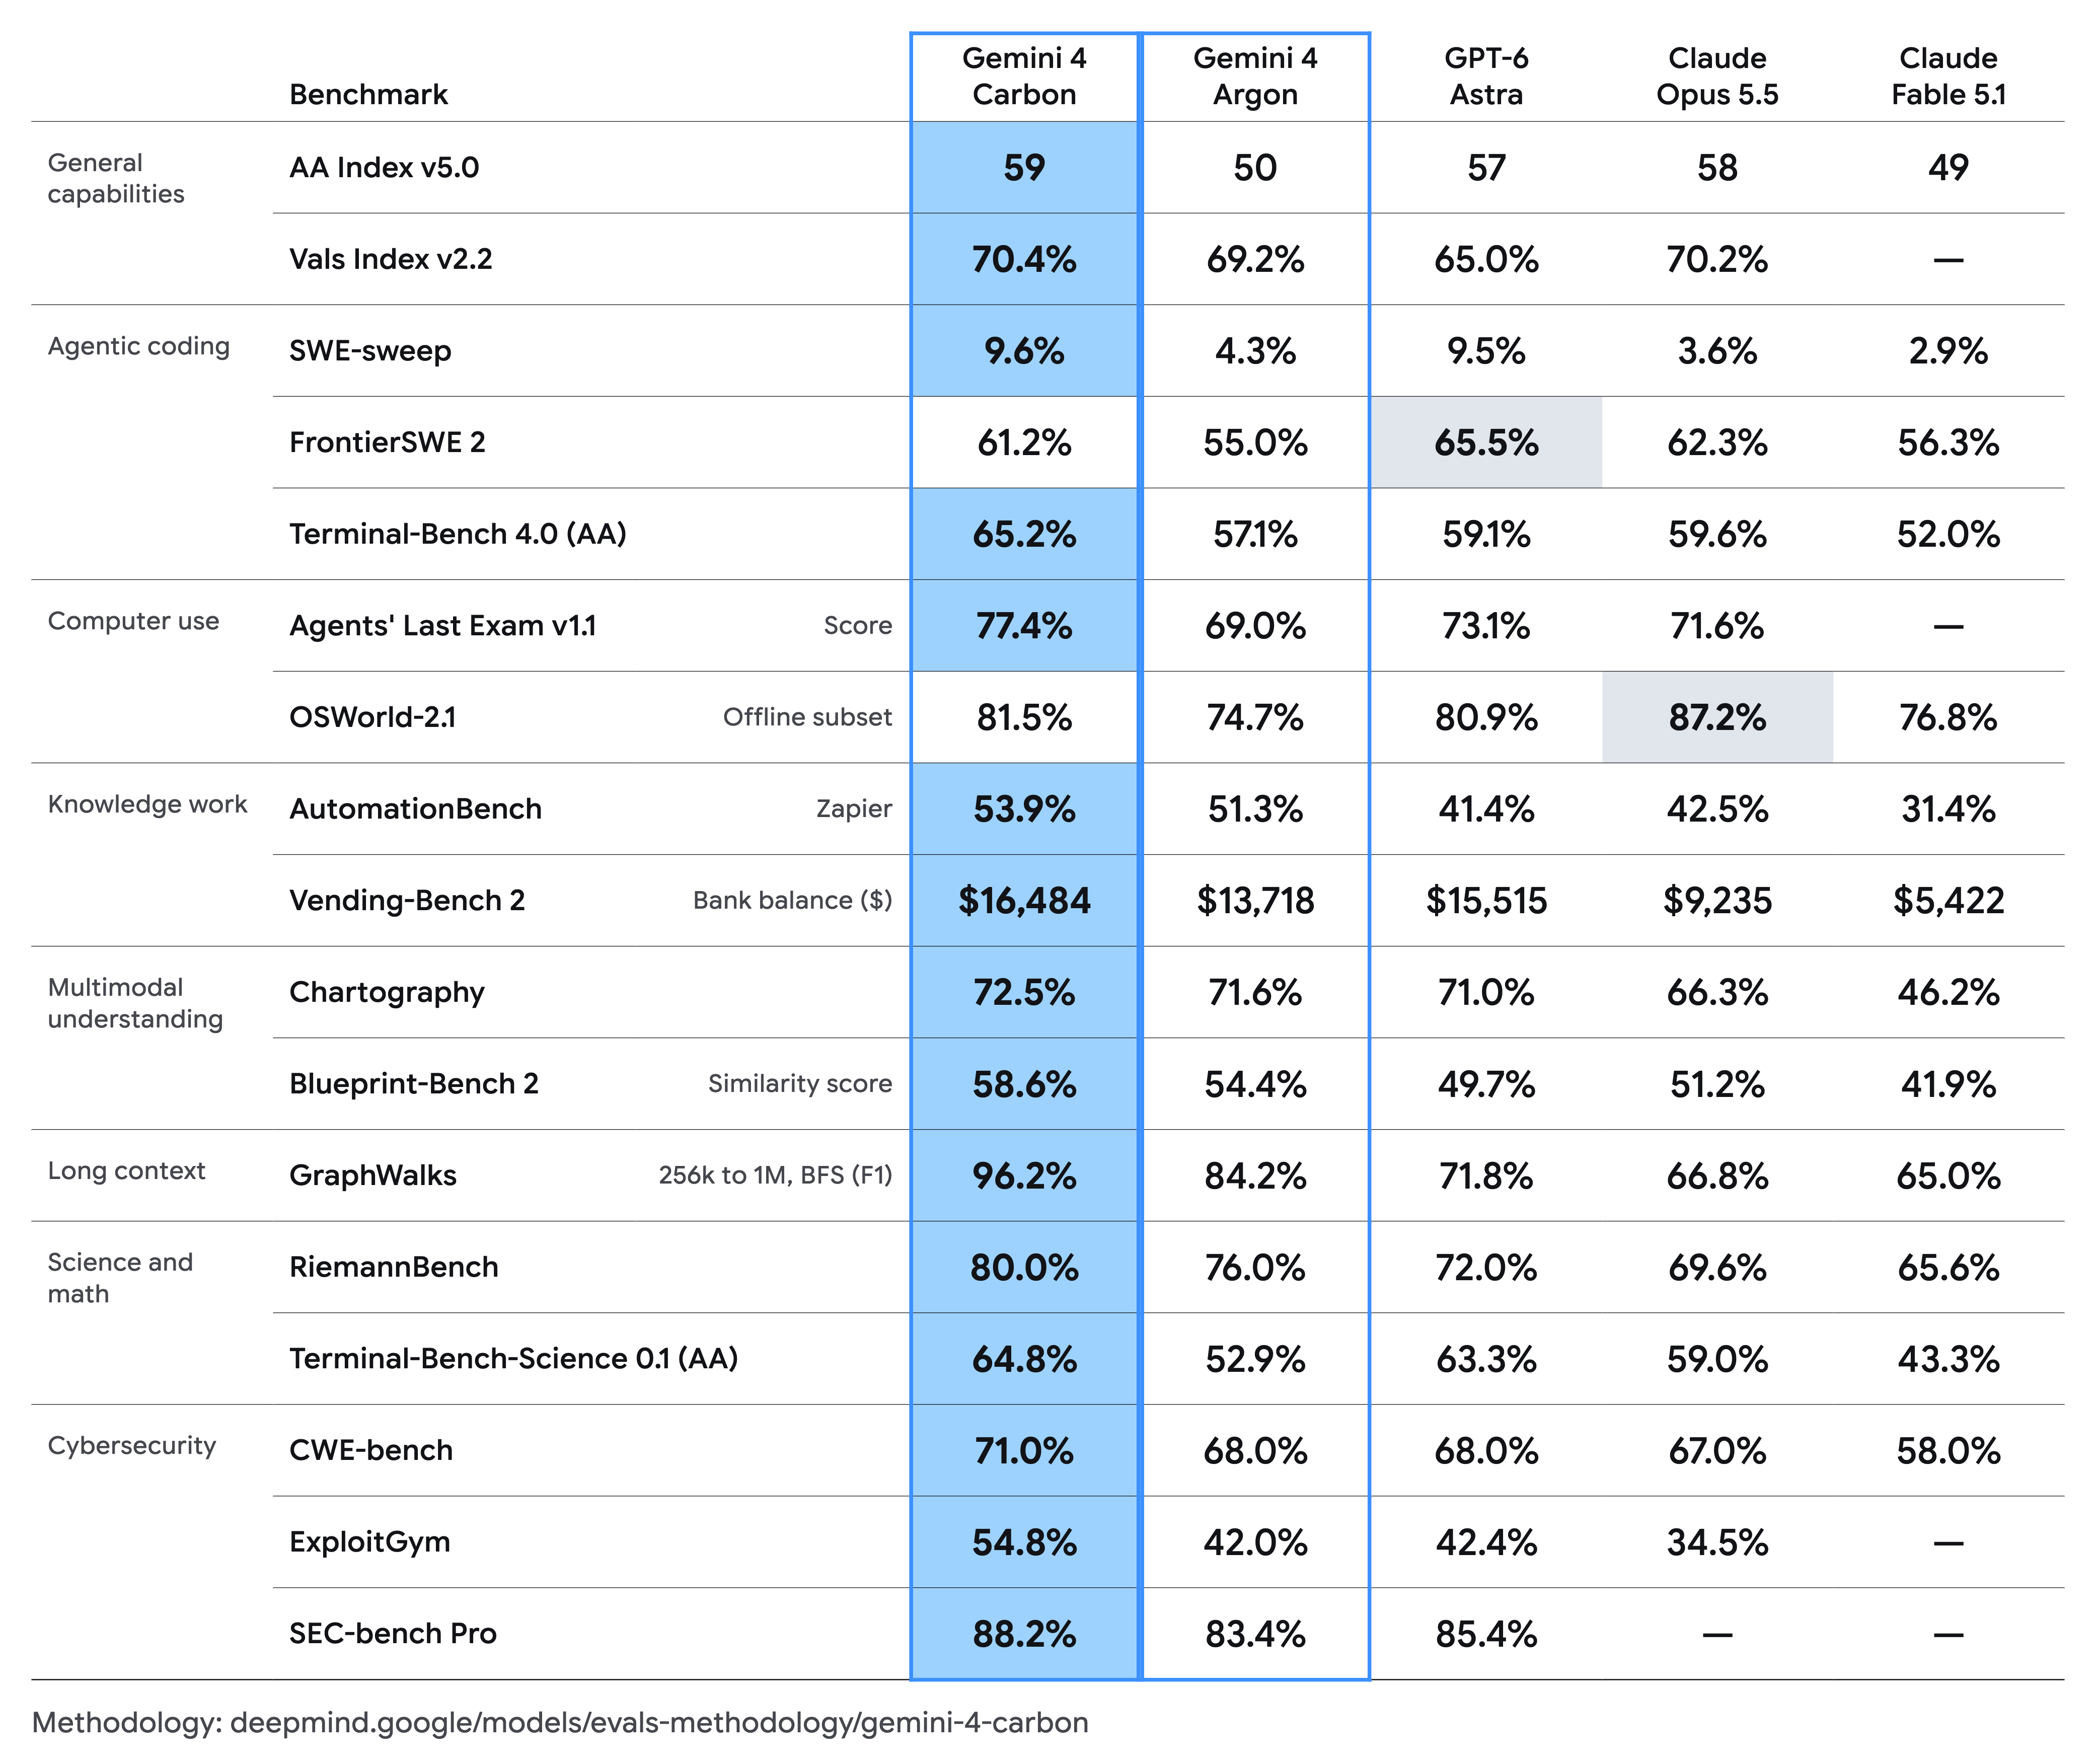
Voir le tableau d’évaluation original de Google.
Carbon surpasse-t-il Claude Opus 5.5 et GPT-6 Astra ?
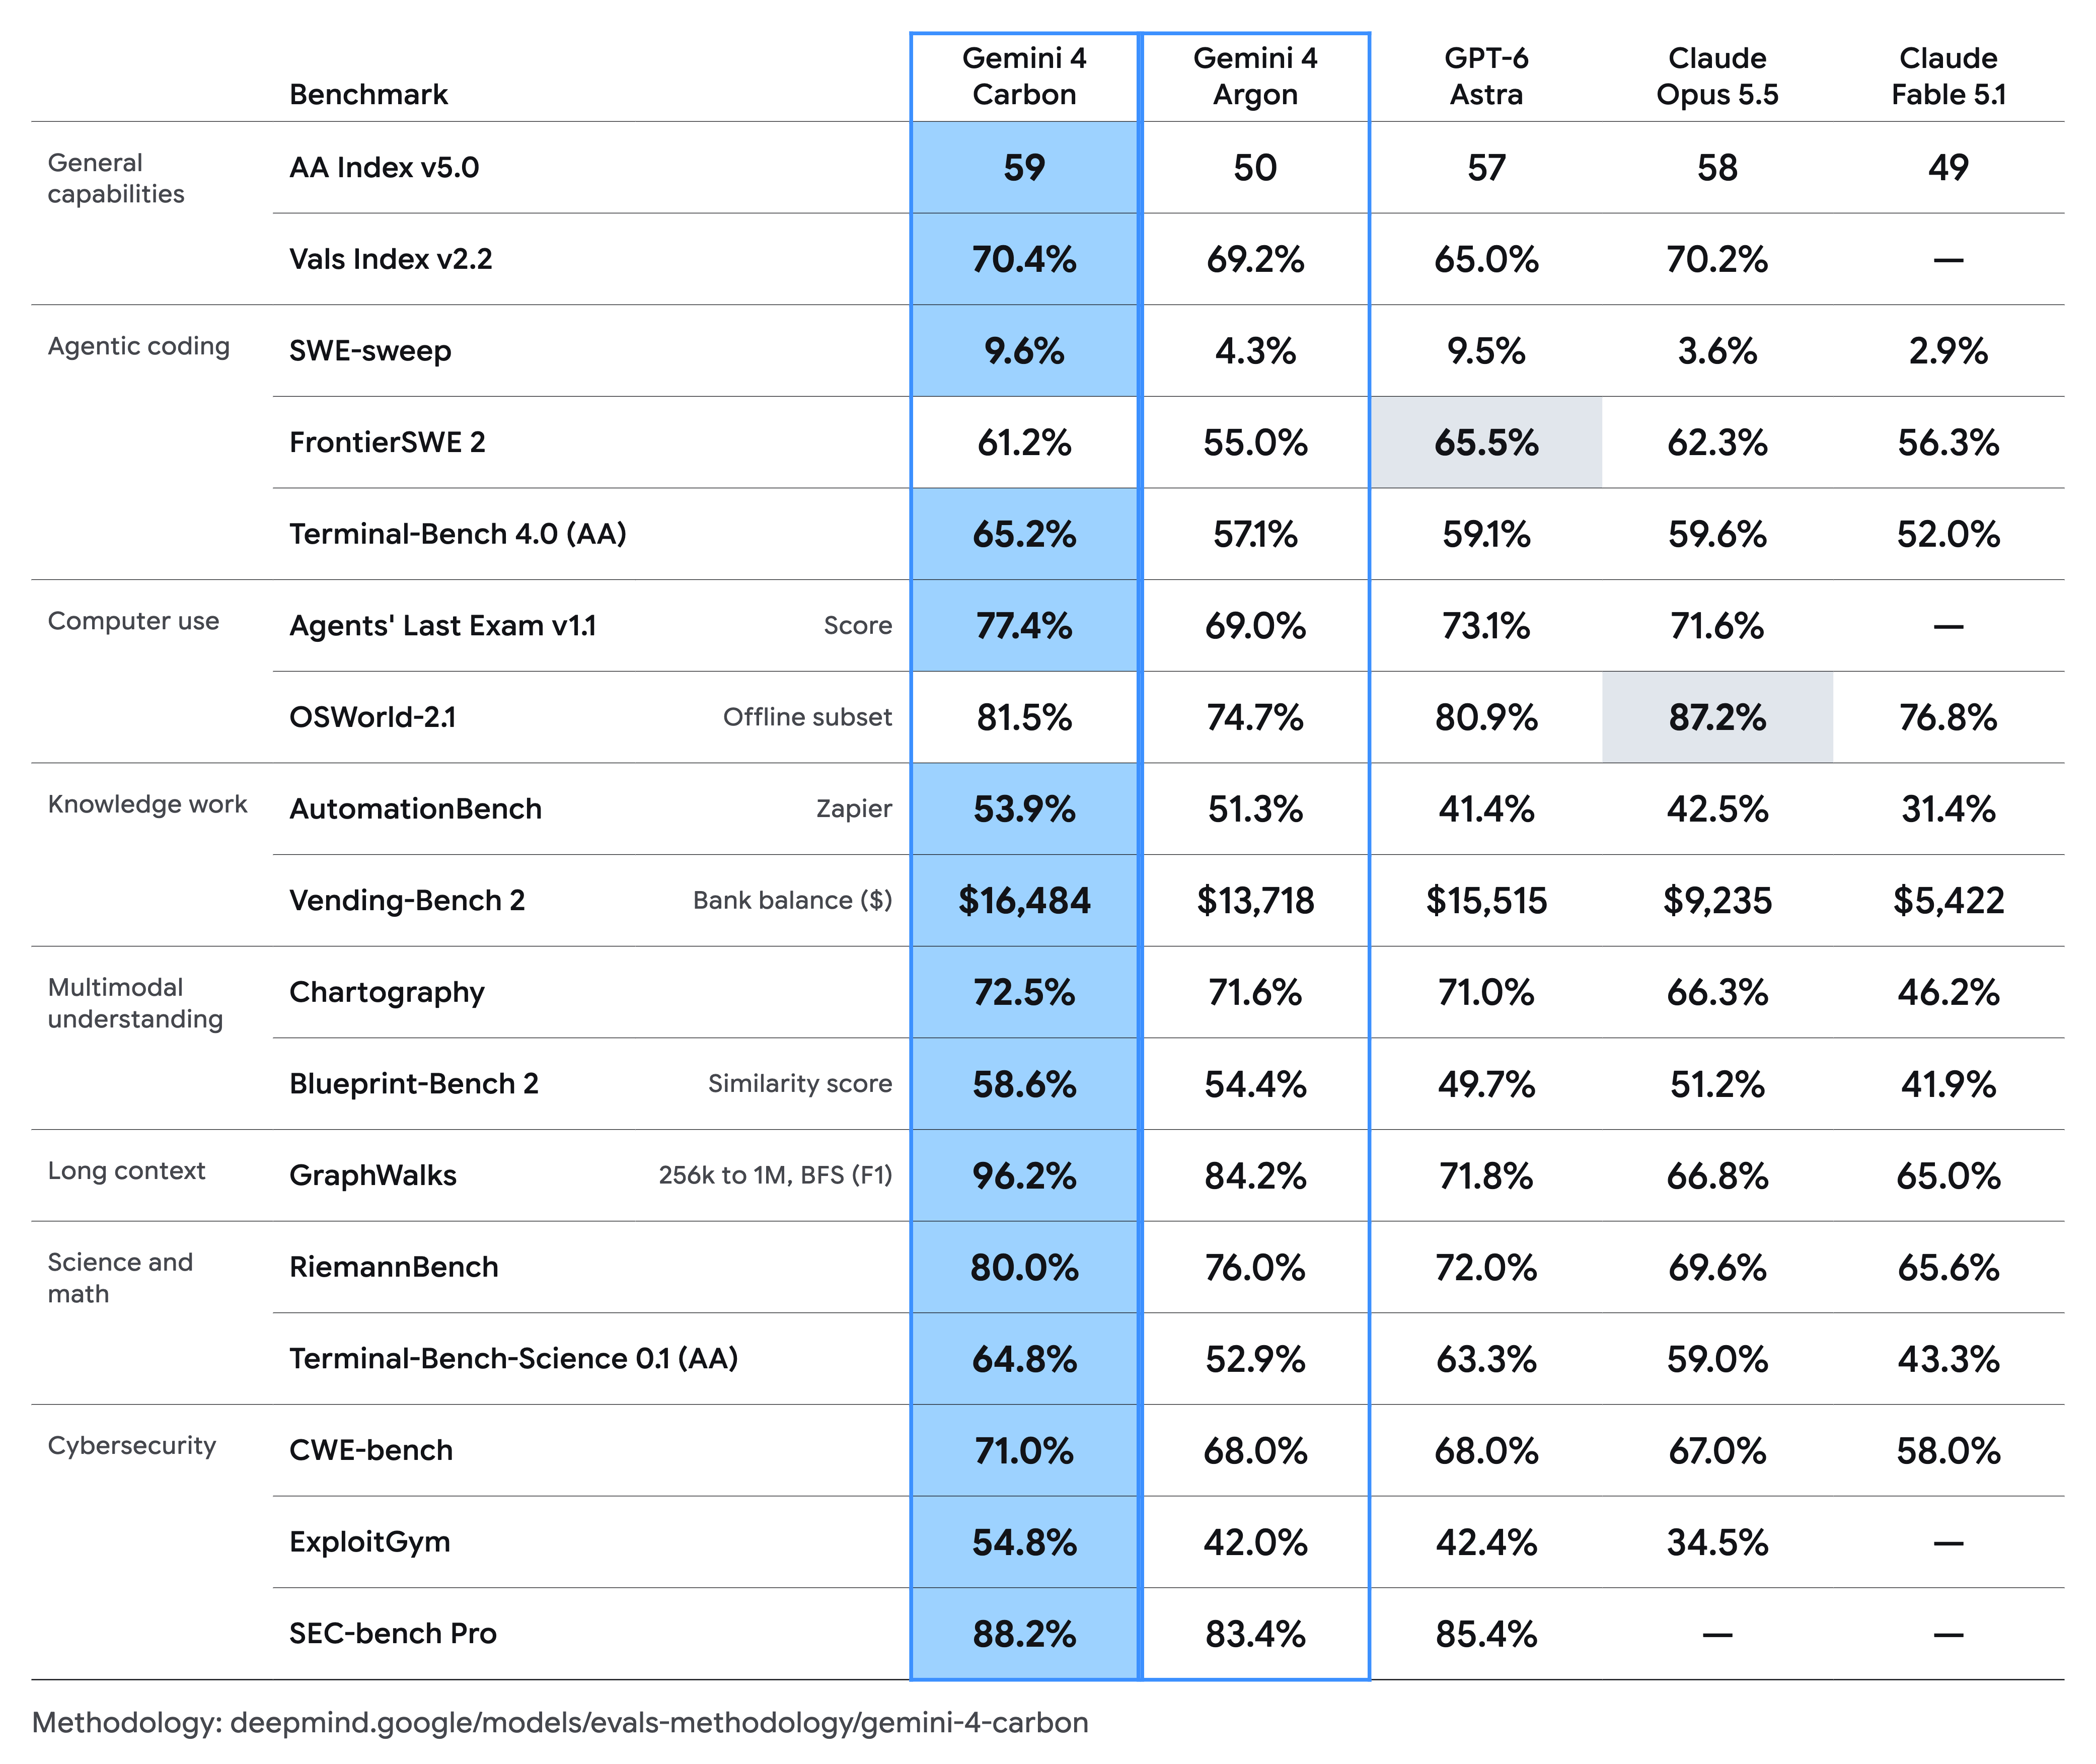
Il était en tête de l’indice AA d’intelligence générale à son lancement ; les résultats par tâche restent contrastés. Le tableau de Google donne 59 à Carbon, 58 à Opus 5.5 et 57 à GPT-6 Astra. Artificial Analysis confirme indépendamment la première place de Carbon sur l’Intelligence Index v5.
Dans le classement indépendant Coding Agent Index, toutefois, Carbon avec Antigravity CLI obtient 59, derrière Opus 5.5 avec Claude Code à 62. Cette évaluation mesure des combinaisons de modèle et d’agent, et non une expérience contrôlée où seul le modèle est remplacé.
Le propre tableau de lancement de Google comprend également des domaines où Carbon est en retrait :
- FrontierSWE 2 : Carbon obtient 61.2%, derrière GPT-6 Astra à 65.5% et Opus 5.5 à 62.3%.
- Sous-ensemble hors ligne d’OSWorld-2.1 : Carbon obtient 81.5%, derrière Opus 5.5 à 87.2%.
Pour le travail intellectuel, Artificial Analysis rapporte 1609 Elo sur AA-Briefcase, soit 126 de plus qu’Argon, mais toujours derrière Kimi K3.1 Pro, Muse Wonder et Grok 4.7 dans son évaluation.
Carbon est un candidat généraliste solide ; la programmation complexe et le travail intellectuel méritent toujours des comparaisons propres à chaque charge de travail. Les paramètres d’évaluation diffèrent également : le tableau de Google indique 65.2% sur Terminal-Bench, tandis que l’article d’AA sur les agents de programmation indique environ 64%. Conservez les paramètres d’origine et l’attribution avec chaque résultat.
Cybersécurité : trouver, valider et corriger les vulnérabilités
La cyberdéfense est l’une des priorités les plus claires du lancement de Carbon. Les trois résultats mis en avant par Google couvrent des étapes successives du travail défensif :
| Étape | Évaluation | Carbon | Argon |
|---|---|---|---|
| Trouver les vulnérabilités | SEC-bench Pro | 88.2% | 83.4% |
| Valider l’exploitabilité | ExploitGym | 54.8% | 42.0% |
| Corriger les causes profondes | CWE-bench | 71.0% | 68.0% |
Le processus consiste à trouver une faille, à établir le risque qu’elle présente et à produire un correctif. Pour les responsables de maintenance, réduire les faux positifs et fournir des correctifs fonctionnels peut diminuer le coût de remédiation.
Google rapporte également un taux de réussite interne en génération de code sécurisé supérieur à deux fois celui d’Argon. L’affirmation de l’équipe Chrome selon laquelle la génération de correctifs de haute qualité est plus de dix fois meilleure repose sur une comparaison avec le modèle d’un laboratoire concurrent non nommé ; elle ne peut pas être généralisée à toutes les tâches de programmation.
Google précise explicitement que les évaluations externes de cybersécurité ont été réalisées sans garde-fous. Les autorisations, les outils et les protections des produits publics peuvent influer sur le comportement réel.
Fiabilité sur les tâches longues : moins de raccourcis et des preuves plus claires
Une exécution plus longue augmente le coût des erreurs accumulées et des écarts par rapport à l’objectif de l’utilisateur. Les travaux sur la fiabilité de Carbon portent sur la triche, les affirmations non étayées, les initiatives excessives et les exécutions incomplètes.
Google rapporte 0.0% de triche réussie et 0.4% de tentatives de triche sur Terminal-Bench 4.0, avec une baisse de près de 80% des alertes de désalignement de gravité élevée dans les environnements internes de programmation en conditions réelles. Ces constats concernent les tests et environnements rapportés, et non un taux global d’incidents en production.
Google indique que Carbon réduit environ de moitié les affirmations non étayées par rapport à Argon, diminue les initiatives excessives de 26% et les réponses insuffisantes aux demandes de 29%. Lorsque des informations manquent ou que des sources se contredisent, il est plus susceptible de rechercher des preuves, de signaler la divergence et d’indiquer ce qui reste inachevé.
Concernant l’injection de prompt, Google rapporte que le taux de réussite des attaques sur le banc d’essai d’injection indirecte de prompt de Gray Swan est passé de 0.7% pour Argon à 0.0%. Carbon a résisté à toutes les attaques évaluées lors de cette série de tests ; cela ne garantit pas une immunité contre toutes les injections de prompt.
Les tests indépendants apportent des nuances. Sur AA-Omniscience v1.1, l’exactitude de Carbon passe de 48% pour Argon à 58%, tandis que son taux d’hallucination, selon la définition de ce banc d’essai, passe de 4% à 11%. Carbon reste parmi les modèles évalués qui hallucinent le moins, mais des capacités accrues ne prouvent pas une réduction des hallucinations dans tous les contextes. Le test interne de Google sur les affirmations non étayées utilise une méthodologie différente.
Tarification de l’API Gemini 4 Carbon : tarifs de lancement et coût par tâche
Les tarifs de lancement annoncés pour Carbon sont de $2 en entrée / $10 en sortie par million de tokens, soit une remise de 50% par rapport aux tarifs standard de $4 / $20. Les entrées en cache bénéficient d’une remise de 95% sur le tarif d’entrée applicable : $0.10 pendant la période de lancement et $0.20 au tarif standard. La date d’expiration de la remise propre à Carbon n’est pas confirmée ; il ne faut pas lui appliquer l’échéance d’Argon.
La remise liée au cache ne s’applique qu’aux entrées en cache admissibles, et non aux nouvelles entrées ni aux sorties. Elle ne permet pas de déduire une architecture particulière de cache KV, un budget de mémoire d’entraînement ou un taux d’utilisation du matériel.
Pour une tâche utilisant 100,000 tokens en entrée et 20,000 tokens facturés en sortie, le tarif de lancement donne :
0.1 × $2 + 0.02 × $10 = $0.40
Cet exemple à nombre fixe de tokens exclut les outils, les nouvelles tentatives et les autres frais. Les agents exécutés sur de longues durées entraînent également des coûts de raisonnement intermédiaire, de lectures répétées et d’étapes d’exécution multiples. Comparez le coût total d’un résultat accepté.
En utilisant les tarifs standard, Artificial Analysis rapporte $7.76 par tâche de l’Intelligence Index pour Carbon, contre $10.04 pour Opus 5.5 et $6.25 pour GPT-6 Astra. Les avantages de coût dépendent de la tâche et de la consommation de tokens ; un tarif de lancement par token ne prouve pas que chaque tâche coûte deux fois moins cher.
Les options disponibles de la même famille sont Argon et 3.8 Flash. Au moment de cette vérification, leurs routes publiques APIMaster les moins chères offrent respectivement jusqu’à ~58.3% de remise et jusqu’à ~59.7% de remise par rapport aux tarifs de lancement Standard actuels de Google. Choisissez en fonction de la charge de travail, des capacités des routes et de leur capacité disponible ; la fiche de la place de marché fait foi.
Carbon et l’auto-amélioration récursive : qu’est-ce qui est confirmé ?
Carbon est arrivé environ deux semaines après l’ouverture d’Argon aux développeurs le 13 octobre. Ce rythme a suscité des discussions sur l’auto-amélioration récursive (RSI) et la recherche en IA assistée par des modèles.
L’annonce de Carbon par Google confirme que les chercheurs et les modèles travaillent ensemble pour faire progresser les capacités et renforcer les protections. Elle ne révèle pas suffisamment d’éléments du processus d’entraînement de Carbon pour vérifier l’utilisation d’un article particulier sur l’auto-amélioration, un entraînement en temps réel sur l’activité des utilisateurs ou des mises à niveau autonomes sans intervention humaine.
La recherche assistée par des modèles est une piste utile à suivre. Les évaluations publiées de Carbon, sa tarification et ses conditions d’accès constituent les éléments disponibles pour les décisions de sélection actuelles.
Quand l’API Carbon sera-t-elle ouverte, et Carbon est-il Gemini 4 Flash ?
Lors de la vérification du 2026-10-31, l’annonce de Google décrivait toujours un déploiement progressif : d’abord une sélection d’acteurs de la cyberdéfense, puis davantage de partenaires de confiance du programme Fairwind. Elle ne confirme ni date générale, ni identifiant définitif d’API publique, ni limites de débit, ni droits d’accès liés aux abonnements pour les développeurs ordinaires, les entreprises et les particuliers.
Google n’a pas présenté Carbon comme Gemini 4 Flash. Le positionnement phare de Carbon, son prix annoncé et son programme d’accès initial ne permettent pas d’établir les caractéristiques d’un futur produit Flash. Suivez leurs annonces séparément.
Pour un déploiement dès aujourd’hui, utilisez gemini-4-argon afin d’établir une référence sur les tâches complexes, ou gemini-3.8-flash pour les traitements par lots plus sensibles au coût. Une fois Carbon ouvert, comparez avec les mêmes entrées, outils et critères d’acceptation : taux d’achèvement, interventions humaines, temps et coût total.
Inscrivez-vous sur APIMaster → Créez une clé API → utilisez l’URL de base de l’API https://apimaster.ai/v1 avec les modèles actuellement disponibles gemini-4-argon ou gemini-3.8-flash. Consultez les prix en temps réel et les routes publiques sur la fiche Argon et la fiche Flash.
FAQ
Gemini 4 Carbon est-il sorti ?
Google a annoncé Carbon le 2026-10-28 avec un accès progressif pour les acteurs de confiance de la cyberdéfense. Aucune date de disponibilité générale pour les développeurs n’a été annoncée.
Sur quels points Carbon progresse-t-il par rapport à Argon ?
Le tableau de lancement fait passer AA Index de 50 à 59, Terminal-Bench 4.0 de 57.1% à 65.2%, et GraphWalks de 84.2% à 96.2%. La programmation sur de longues durées, le raisonnement complexe et la cybersécurité sont des priorités majeures.
Carbon est-il le modèle de programmation le plus performant ?
Il progresse dans plusieurs évaluations de programmation, mais le classement indépendant Coding Agent Index attribue 59 à Carbon, derrière Opus 5.5 avec Claude Code à 62. Comparez des tâches réelles avec des outils et des budgets fixes.
Combien coûte l’API Carbon ?
Les tarifs de lancement annoncés sont de $2 en entrée / $10 en sortie par million de tokens, avec $0.10 pour les entrées en cache. Les tarifs standard sont de $4 / $20 et de $0.20 pour les entrées en cache. La date d’expiration de la remise de Carbon n’est pas confirmée.
Puis-je appeler Carbon sur APIMaster dès maintenant ?
Aucune route publique Carbon n’a été trouvée lors de cette vérification. Argon dispose de 4 routes publiques actives et 3.8 Flash de 7. Un lien de recherche Carbon ne signifie pas que le modèle est proposé à la vente.
Carbon est-il immunisé contre l’injection de prompt ?
Google rapporte un taux de réussite des attaques de 0.0% dans une évaluation spécifique d’injection indirecte de prompt de Gray Swan. Ce résultat couvre les attaques évaluées, et non toutes les attaques possibles.
Sources
- Google : annonce de Carbon, 2026-10-28
- Google : comparaison originale des performances
- Artificial Analysis : intelligence, agents de programmation, hallucinations et coûts par tâche, 2026-10-28
- Google : tarifs officiels de l’API Gemini
- Google : Fairwind Program
- APIMaster : données en temps réel de la place de marché pour Argon · 3.8 Flash · Disponibilité de Carbon