
Gemini 4 Argon: o modelo frontier do Google para fluxos de trabalho longos
O Google anunciou o Gemini 4 Argon em 30 de setembro de 2026 para engenharia de software complexa, trabalho de conhecimento empresarial e defesa cibernética. Veja os preços divulgados, benchmarks, o acesso limitado pelo Fairwind e as rotas Gemini disponíveis hoje.
Published 2026-09-30 · Updated 2026-10-01
Gemini 4 Argon é o primeiro modelo de fronteira Gemini 4 anunciado pelo Google, mas ainda não é uma API pública em geral. O Google anunciou o Argon em 30 de setembro de 2026, posicionando-o para engenharia de software de longa duração, trabalho de conhecimento empresarial e defesa cibernética. O primeiro acesso descrito pelo Google é por meio do programa Fairwind para defensores cibernéticos confiáveis; uma ampla API paga ou data de lançamento do Google AI Ultra não foi anunciada. A capacidade do título é relatada até 1 milhão de tokens de saída em uma resposta, em comparação com os limites de saída muito menores aos quais os desenvolvedores estão acostumados na maioria das APIs de fronteira atuais. O Google diz que suas equipes internas já estão usando Argon para grandes refatoradores, migrações de C/C++ para Rust, otimização de memória e outras tarefas de longo prazo. A tabela de benchmark publicada com o anúncio informa 77,9% no DeepSWE v1.1, 68,9% no trabalho de conhecimento do Vals Index, 19,6% no Harvey's Legal Agent Benchmark e fortes resultados em várias outras avaliações empresariais e de codificação. Estes são resultados publicados pelo fornecedor, não um teste APIMaster independente. O preço inicial relatado é de US$ 2/1 milhão de tokens de entrada e US$ 10/1 milhão de tokens de saída, com entrada em cache relatada em cerca de US$ 0,10/1 milhão de tokens. Espera-se que o Google mude para US$ 4/US$ 20 após o período introdutório, mas o catálogo público da API e uma rota Argon geralmente disponível devem ser tratados como a fonte da verdade quando aparecerem. Argon atualmente não tem rota APIMaster confirmada. Para uma API Gemini que você pode chamar hoje, o APIMaster tem rotas ativas para Gemini 3.8 Flash, Gemini 3.7 Flash e Gemini 3.6 Flash. Conforme verificado em 1º de outubro de 2026, a rota ativa mais baixa do Gemini 3.8 Flash foi de $0,2999 de entrada / $1,4993 de saída por 1 milhão de tokens, com sete rotas ativas. Verifique o cartão ao vivo antes de enviar tráfego porque a capacidade da rota e os preços podem mudar.
| ID do modelo | Preço de tabela oficial (por 1 milhão de entrada/saída) | Preço atual do APIMaster | Rotas ativas | Desconto | Cartão modelo |
|---|---|---|---|---|---|
gemini-4-argon |
Introdução relatada $ 2 / $ 10; mais tarde $4 / $20 | Nenhuma via pública confirmada | 0 | — | Ver modelo de cartão |
gemini-3.8-flash |
$ 1,50 / $ 7,50 | US$ 0,2999 / US$ 1,4993 | 7 | cerca de 80% | Ver desconto |
gemini-3.7-flash |
$ 1,50 / $ 7,50 | US$ 0,2999 / US$ 1,4993 | 7 | cerca de 80% | Ver desconto |
gemini-3.6-flash |
$ 1,50 / $ 7,50 | US$ 0,36 / US$ 1,80 | 4 | cerca de 76% | Ver desconto |
gpt-6-astra |
$ 10 / $ 50 | US$ 0,4465 / US$ 2,2327 | 14 | cerca de 96% | Ver desconto |
claude-fable-5-1 |
$ 10 / $ 50 | US$ 2,3755 / US$ 11,8774 | 7 | cerca de 76% | Ver desconto |
claude-opus-5-5 |
US$ 4/US$ 20 | US$ 1,3359 / US$ 6,6794 | 9 | cerca de 67% | Ver desconto |
| Snapshot de preços verificado em 1º de outubro de 2026. Os preços do APIMaster são a rota ativa mais baixa retornada pelo endpoint do mercado público naquele momento; o cartão do mercado ao vivo é oficial. O preço e a disponibilidade do Argon são informações de lançamento relatadas, não uma listagem confirmada do APIMaster. |
Teste do GPT(GPT-6 Astra, GPT-6 Sol, GPT-5.6 e GPT-5.5 disponíveis)
Cadastre-se e receba $20 de teste do GPT
O que é Gêmeos 4 Argônio?
Gemini 4 Argon é o primeiro membro anunciado da geração Gemini 4 do Google. Ao contrário de um lançamento voltado para o consumidor focado em recursos de chat, o Google apresentou o Argon como um modelo de trabalho que exige muitas etapas, usa grandes quantidades de contexto e pode ser executado por um longo tempo antes de produzir um resultado útil. Para obter o cronograma mais amplo de treinamento e disponibilidade do Gemini 4, consulte a visão geral do Gemini 4. As três áreas de lançamento são:
- Engenharia de software: alterações em escala de repositório, depuração, migrações e loops de agente de codificação.
- Trabalho de conhecimento empresarial: pesquisa jurídica, financeira e operacional em que o modelo deve rastrear muitas restrições e fontes.
- Defesa cibernética: análise de segurança defensiva divulgada primeiro para participantes confiáveis do programa Fairwind do Google. Este posicionamento é importante para os compradores de API. Uma pontuação de referência elevada não é o mesmo que disponibilidade pública, latência previsível ou um contrato de faturação estável. Até que o Argon seja listado na documentação da API do Google com um ID de modelo e limites, os desenvolvedores devem tratar o anúncio como uma atualização de capacidade e acesso – não como um endpoint que eles podem chamar.
O que o Argônio pode fazer?
Teto de produção de um milhão de tokens
O anúncio do Google destaca um máximo de 1 milhão de tokens de saída em uma única resposta. Se o limite for entregue conforme descrito, poderá mudar a forma como os desenvolvedores projetam grandes refatoradores, relatórios longos e fluxos de trabalho de agentes em vários estágios: o modelo pode ser capaz de manter mais resultados intermediários de uma tarefa em uma resposta, em vez de forçar o aplicativo a dividir o trabalho em muitas chamadas de continuação. Esse número não deve ser confundido com produção útil garantida, capacidade de contexto, limites de taxa ou utilização de produção acessível. Uma resposta de um milhão de tokens também é uma conta de um milhão de tokens na taxa de produção. As equipes devem medir a qualidade de conclusão, o comportamento de cancelamento, a latência e o custo total em tarefas representativas antes de tratar o limite como um motivo para remover os pontos de verificação do lado da aplicação.
Trabalho de engenharia e conhecimento de longo horizonte
O Google descreve projetos internos do Argon que incluem otimização de memória do data center, migrações C/C++ para Rust e aceleração de decodificador de vídeo. Estes exemplos são sinais úteis sobre a carga de trabalho pretendida, mas são estudos de caso internos e não avaliações públicas reproduzíveis. O teste de produção correto é executar um repositório fixo ou conjunto de documentos em relação ao Argon e às alternativas atuais com as mesmas ferramentas, orçamento e rubrica de classificação.
Defesa cibernética em primeiro lugar
O acesso inicial ao Fairwind é uma parte significativa da história do produto. Isso significa que os primeiros usuários são defensores cibernéticos confiáveis, e não a população geral de desenvolvedores. Isso pode permitir que o Google aprenda com fluxos de trabalho defensivos de alto risco, ao mesmo tempo que mantém o acesso, os controles de abuso e os ciclos de feedback restritos.
Também significa que “anunciado” não significa “disponível no AI Studio, Gemini API ou APIMaster”. Os desenvolvedores não devem copiar um identificador adivinhado como gemini-4-argon na produção e inferir o sucesso de um rótulo de rota de terceiros.
Resultados de benchmark: o que o Google publicou
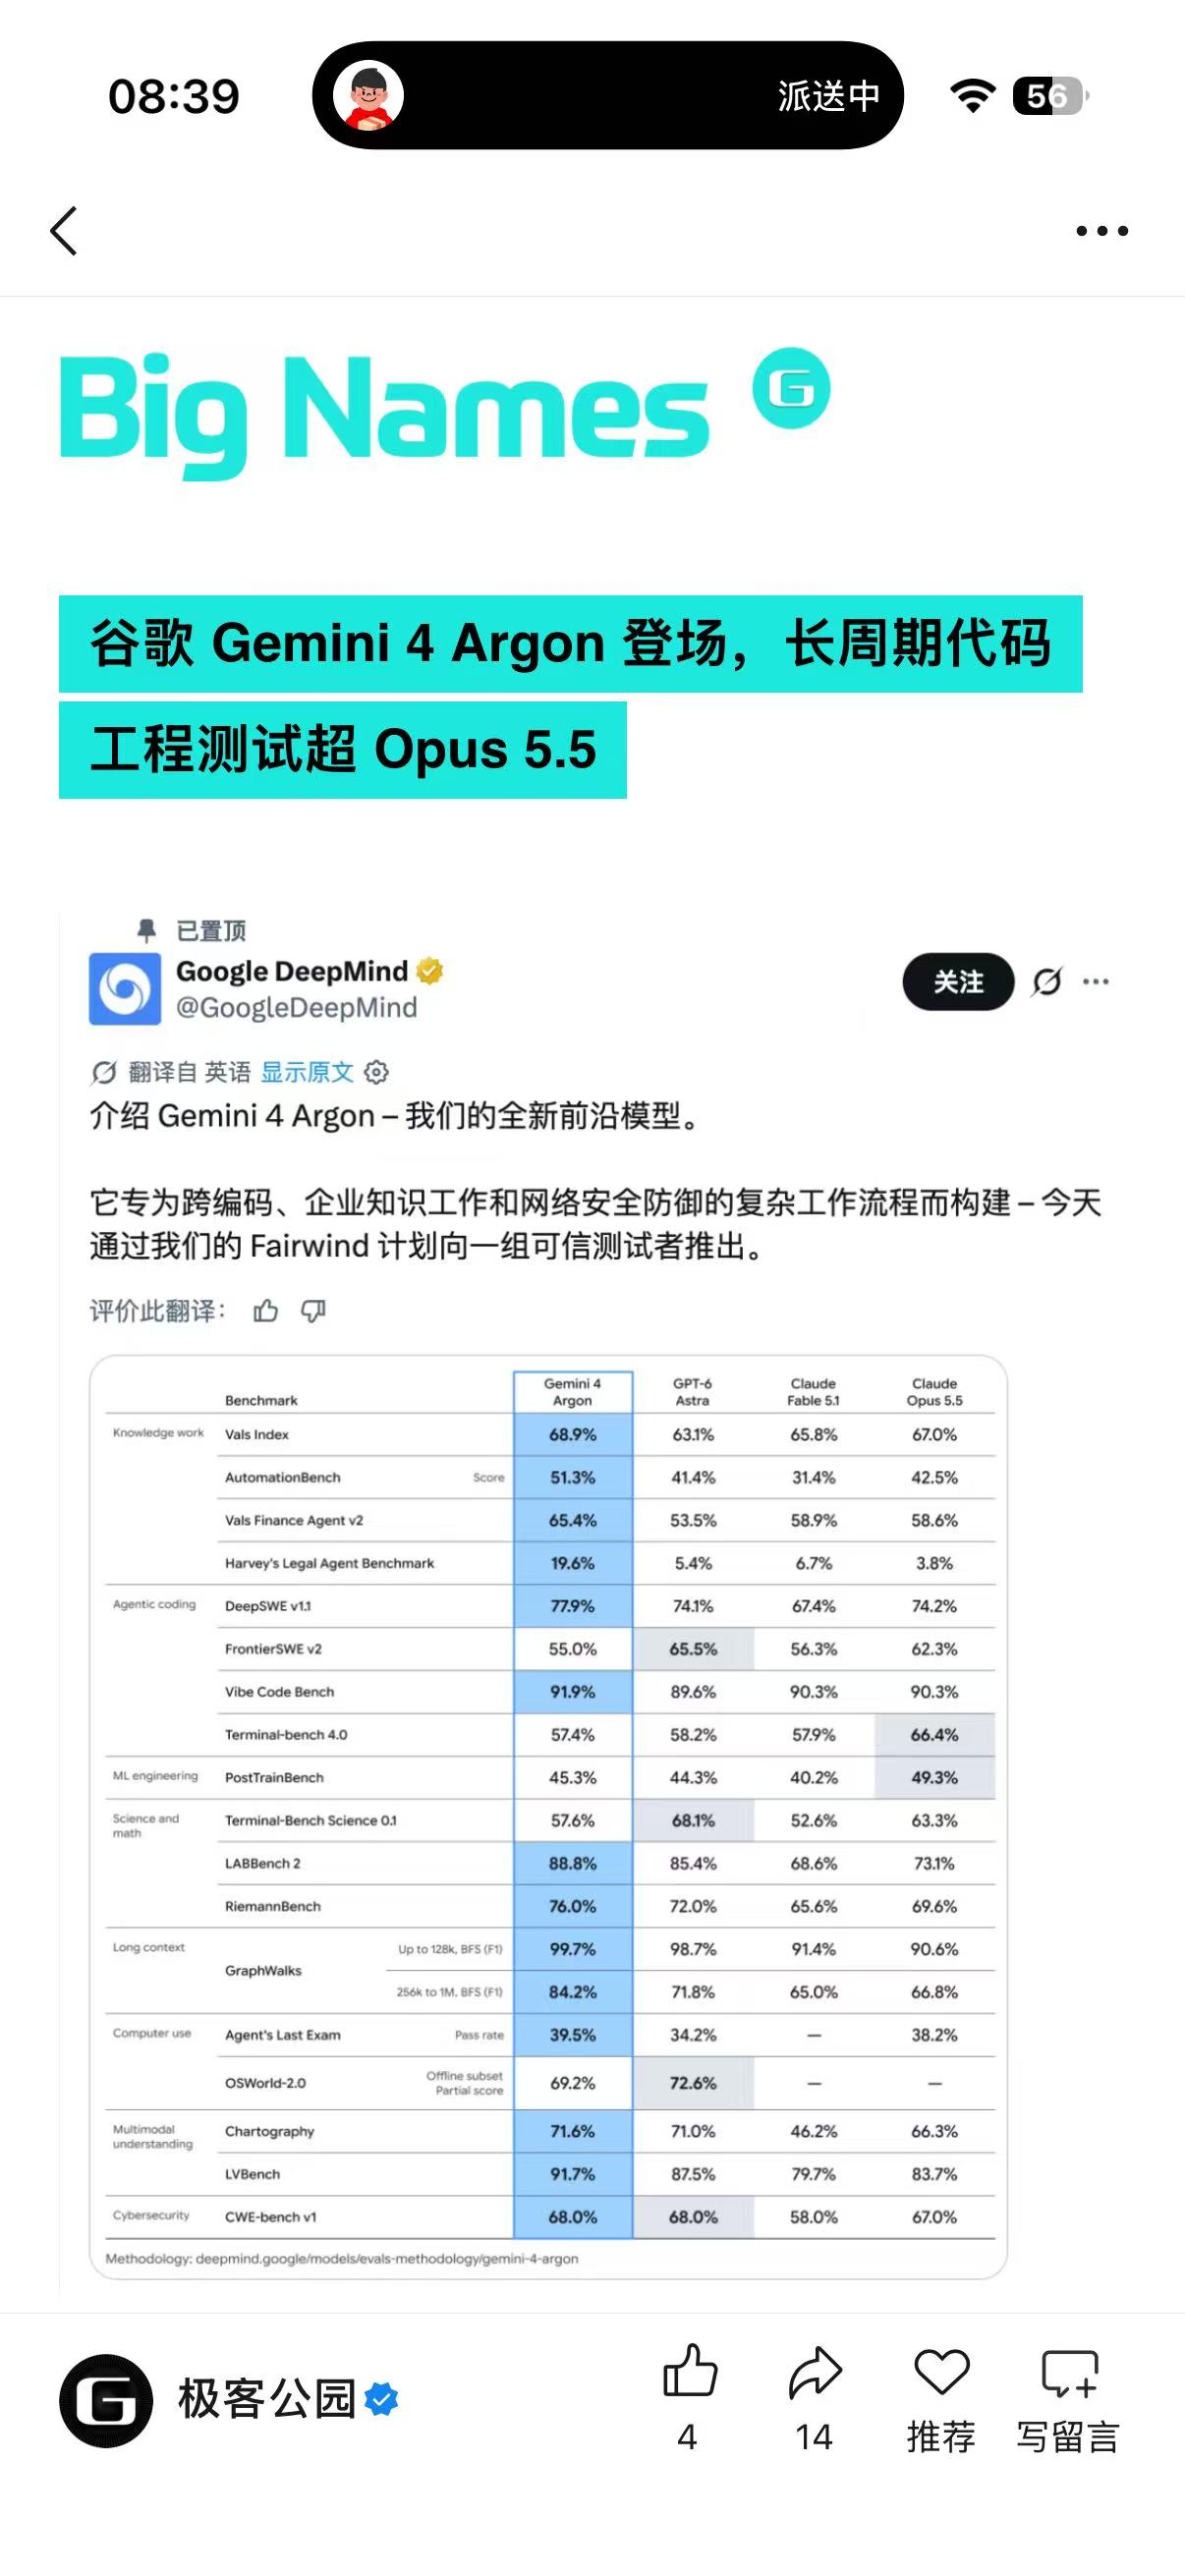
A captura de tela de comparação do anúncio lista Argon ao lado de GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. Os valores representativos mostrados na tabela publicada incluem:
| Avaliação | Gêmeos 4 Argônio | GPT-6 Astra | Cláudio Fábula 5.1 | Cláudio Opus 5.5 |
|---|---|---|---|---|
| Trabalho de conhecimento do Índice Vals | 68,9% | 63,1% | 65,8% | 67,0% |
| Banco de automação | 51,3% | 41,4% | 31,4% | 42,5% |
| Vals Agente Financeiro v2 | 65,4% | 53,5% | 58,9% | 58,6% |
| Referência de agente jurídico de Harvey | 19,6% | 5,4% | 6,7% | 3,8% |
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Banco de código Vibe | 91,9% | 89,6% | 90,3% | 90,3% |
| Bancada terminal 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| Banco CWE v1 | 68,0% | 68,0% | 58,0% | 67,0% |
 |
||||
| Imagem editorial: captura de tela fornecida pelo usuário. A postagem visível é atribuída ao GEEKPark e inclui uma imagem de um suposto anúncio do Google DeepMind; esta não é uma captura original e autenticada de forma independente da postagem X do Google. Verifique a postagem e a metodologia originais antes de tratar as pontuações como validadas de forma independente. | ||||
| A tabela não é uniformemente favorável ao Argônio. A captura de tela mostra o GPT-6 Astra à frente no FrontierSWE v2 e OSWorld-2.0, enquanto Claude Opus 5.5 lidera o Terminal-bench 4.0 e PostTrainBench. É por isso que uma manchete como “Argon vence todos os benchmarks” seria enganosa. Os resultados do Google apoiam uma conclusão mais específica: o Argon é competitivo ou está à frente em muitas avaliações de longo prazo, empresariais e de trabalho defensivo, enquanto outros modelos permanecem mais fortes em tarefas selecionadas de uso de computador, codificação e pós-treinamento. | ||||
| Os comentários independentes já estão divididos. A Análise Artificial descreve o Argon empatado com o GPT-6 Astra em seu Índice de Inteligência e destaca taxas mais baixas de alucinações e melhor comportamento do agente. Outros pesquisadores questionam quanto dessa pontuação vem do comportamento de recusa, da ponderação do benchmark e de uma metodologia que ainda está em mudança. Trate essas afirmações como uma análise externa e não como um substituto para as definições de referência primárias. |
Quem anunciou Argon no X?
A conversa de lançamento está concentrada em torno de um pequeno grupo de contas oficiais e de análise:
- Google DeepMind anunciou o Argon e o primeiro modelo de acesso Fairwind.
- Google enfatizou o teto de produção de um milhão de tokens e os resultados de fronteira.
- Sundar Pichai explicou por que o Google compartilhou o anúncio antecipadamente e enfatizou o uso interno, grades de segurança e acesso encenado.
- Logan Kilpatrick discutiu o preço introdutório relatado de US$ 2/US$ 10 e o plano para expandir o acesso.
- Análise Artificial publicou uma comparação independente e comentários do Índice de Inteligência. A resposta recorrente dos desenvolvedores é direta: os benchmarks parecem atraentes, mas a maioria dos desenvolvedores ainda não pode chamar o Argon. As questões práticas são quando a API paga é aberta, se o Google AI Ultra recebe acesso, quão estáveis são os empregos com milhões de tokens e se o preço inicial sobrevive à disponibilidade geral.
Quais modelos Gemini os desenvolvedores podem usar hoje?
Gêmeos 3.8 Flash
Gemini 3.8 Flash é a rota Gemini mais forte atualmente visível no mercado APIMaster. É uma escolha prática para trabalhos de texto de alto volume, assistentes de codificação, extração estruturada e fluxos de trabalho multimodais, onde um modelo de camada Flash lançado é mais importante do que o posicionamento de fronteira do Argon. Abra o cartão flash Gemini 3.8 ao vivo para provedores atuais, sinais de saúde e preços de rotas. O instantâneo atual do mercado encontrou sete rotas ativas, com a rota mais baixa em cerca de US$ 0,2999/US$ 1,4993 por 1 milhão de tokens de entrada/saída.
Gêmeos 3.7 Flash e 3.6 Flash
O Gemini 3.7 Flash e o Gemini 3.6 Flash continuam sendo escolhas úteis quando uma carga de trabalho precisa de vários canais, um perfil de capacidade específico ou uma versão de modelo já testada pelo aplicativo. O instantâneo encontrou sete rotas 3.7 ativas e quatro rotas 3.6 ativas. Estes não são substitutos do argônio nas reivindicações de capacidade. Estão disponíveis opções Gemini para construir a integração, coletar linhas de base de carga de trabalho e preparar uma mudança de modelo controlada posteriormente.
Outras alternativas de fronteira no APIMaster
Se sua tarefa estiver disponível agora, em vez de esperar pelo Argon, o APIMaster também expõe rotas ativas para GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5.5. A tabela acima usa o mesmo instantâneo do mercado para todos os três, portanto, a comparação separa o preço de referência oficial da rota APIMaster ativa mais baixa. A escolha certa depende da carga de trabalho:
| Carga de trabalho | Comece com | Por que |
|---|---|---|
| Grandes loops de agente de codificação | Gemini 3.8 Flash ou GPT-6 Astra | Compare a conclusão do repositório, os turnos de reparo e a confiabilidade da chamada de ferramenta. |
| Análise jurídica e empresarial | Claude Opus 5.5 ou Fábula 5.1 | Meça a qualidade das citações, o rastreamento de restrições e o comportamento de recusa. |
| Integração Gemini de alto volume | Gêmeos 3.7 Flash ou 3.8 Flash | Mantenha o provedor e o formato da API estáveis enquanto o acesso ao Argon é limitado. |
| Pesquisa de segurança-defesa | Um modelo lançado atualmente com ferramentas aprovadas | Não envie dados confidenciais para uma rota Argon não verificada. |
Como se preparar para a API Argon
Não crie código de produção em torno de um endpoint não confirmado. Em vez de:
- Mantenha os prompts, ferramentas, acessórios de entrada e critérios de classificação versionados.
- Estabeleça uma linha de base com uma rota Gemini liberada e pelo menos uma alternativa não-Gemini.
- Registre a qualidade de saída aceita, o sucesso da chamada de ferramenta, a latência, as novas tentativas, o uso de token e o custo.
- Quando o Google publicar a documentação da API Argon, teste o ID exato do modelo em um ambiente separado.
- Divulgue-o somente após verificação do modelo de cartão, limites, política de segurança e comportamento de cobrança. Uma solicitação mínima compatível com OpenAI por meio do APIMaster fica assim quando você escolhe um modelo lançado:
curl "$API_BASE/v1/chat/completions" \
  -H "Authorization: Bearer $APIMASTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.8-flash",
    "messages": [{"role": "user", "content": "Summarize this repository plan."}]
  }'
Crie uma conta APIMaster, adicione uma chave no console, use a API base e selecione um modelo que apareça no mercado ativo. Não substitua gemini-3.8-flash por gemini-4-argon até que o Google e o catálogo de rotas confirmem esse identificador.
Resultado final
Gemini 4 Argon é um anúncio importante porque tem como alvo a parte da fronteira onde a qualidade do modelo é medida pela conclusão de fluxos de trabalho longos e confusos, em vez de responder a um único prompt. A tabela publicada pelo Google apresenta fortes resultados em trabalho de conhecimento, agente jurídico, engenharia de software e avaliações de segurança cibernética, e o teto de produção de um milhão de tokens relatado é extraordinariamente ambicioso. Mas o lançamento é deliberadamente encenado. A partir de 1º de outubro de 2026, Argon não é uma API Gemini geralmente disponível ou uma rota APIMaster confirmada. A ação útil hoje é avaliar sua carga de trabalho real em uma rota Gemini lançada – especialmente Gemini 3.8 Flash – ou em outro canal de fronteira ativo e, em seguida, manter o equipamento de avaliação pronto para a eventual API pública do Argon.
Perguntas frequentes
O Gemini 4 Argon está disponível por meio da API Gemini?
Geralmente não. O Google anunciou o Argon em 30 de setembro de 2026 e descreveu o acesso inicial por meio do Fairwind para defensores cibernéticos confiáveis. Um amplo lançamento de API paga não foi confirmado nas informações públicas abordadas aqui.
Posso usar o Gemini 4 Argon através do APIMaster?
Não há rota APIMaster Argon confirmada em 1º de outubro de 2026. Use um modelo lançado mostrado no mercado ao vivo, como gemini-3.8-flash, e verifique o cartão do modelo antes de integrar.
Quanto custa o Gemini 4 Argônio?
O preço introdutório relatado é de US$ 2 por 1 milhão de tokens de entrada e US$ 10 por 1 milhão de tokens de saída, com entrada em cache relatada perto de US$ 0,10. Um preço posterior de US$ 4/US$ 20 também foi relatado. Trate ambos como relatórios de lançamento até que a página pública de preços da API do Google publique o contrato final.
Qual é o contexto ou limite de saída do Argon?
O material de lançamento destaca até 1 milhão de tokens de saída em uma única resposta. Os desenvolvedores ainda precisam verificar os limites de contexto, limites de taxa, latência, comportamento de truncamento e cobrança na eventual documentação da API.
Argon venceu GPT-6 Astra e Claude Opus 5.5 em todos os lugares?
A comparação do Google mostra Argon à frente ou competitivo em muitas avaliações listadas, mas GPT-6 Astra e Claude Opus 5.5 lideram tarefas selecionadas de codificação, uso de computador e pós-treinamento. A metodologia de benchmark e o ajuste da carga de trabalho são importantes.
Qual modelo Gemini devo usar hoje?
Comece com a rota Gemini lançada que corresponda à sua carga de trabalho e apareça no catálogo ativo. O snapshot de 1º de outubro de 2026 encontrou rotas APIMaster ativas para Gemini 3.8 Flash, Gemini 3.7 Flash e Gemini 3.6 Flash. Verifique o cartão Flash Gemini 3.8 para obter o preço atual e a disponibilidade do fornecedor.
Fontes e notas de verificação
- Google DeepMind em X – principal conta de anúncio referenciada na captura de tela de lançamento.
- Google em X — anúncio do produto e enquadramento de acesso.
- Sundar Pichai em X — acesso faseado, uso interno e contexto de segurança.
- Logan Kilpatrick em X — Gemini API e relatou discussão introdutória sobre preços.
- Análise Artificial em X — benchmark independente e comentário do Índice de Inteligência.
- Modelos Google DeepMind Gemini — referência oficial da família de modelos.
- Documentação do modelo Google AI for Developers - a disponibilidade do modelo de API deve ser verificada aqui quando o Argon for aberto. Os números de benchmark e os detalhes de acesso ao Argon neste artigo são atribuídos ao material de lançamento e claramente separados do instantâneo do mercado APIMaster ao vivo. Verifique novamente ambos antes de tomar uma decisão de produção.